Reasoning-Modelle: Warum die höchste Denkstufe selten lohnt

KI- und Digital-Experte bei DigiRift
Dienstagmorgen, 7:40 Uhr. Martin Brandt, IT-Leiter bei einem Zulieferer mit 95 Mitarbeitenden bei Reutlingen, öffnet die Monatsabrechnung seines KI-Anbieters. Knapp 2.900 Euro. Im Vormonat waren es gut 1.000 Euro. An den Prozessen hat niemand etwas geändert: derselbe Angebots-Assistent, dieselbe Dokumentenprüfung, dieselbe Zahl an Anfragen.
Brandt greift zum Telefon. Nach zwanzig Minuten steht die Erklärung. Beim letzten Update hat jemand die Denkstufe der eingesetzten Reasoning-Modelle von „mittel" auf „maximal" gestellt.
Eine Zeile Konfiguration, in guter Absicht geändert. Gemessen hat niemand, ob die Ergebnisse dadurch besser wurden. Sie wurden es nicht.
Solche Rechnungen liegen derzeit auf vielen Schreibtischen im Mittelstand, und fast immer folgt derselbe Reflex: Mehr Rechenaufwand muss doch mehr Qualität bedeuten. Diese Annahme ist der teuerste Irrtum im Betrieb von Reasoning-Modellen. Die folgenden Abschnitte zeigen, warum die höchste Denkstufe selten etwas beiträgt und welche zwei Hebel stattdessen wirken.
Die Einstellung, die in den meisten Betrieben nie jemand angefasst hat
Reasoning-Modelle sind Sprachmodelle, die vor der eigentlichen Antwort eine interne Denkspur erzeugen, und die Länge dieser Denkspur ist einstellbar. Aktuelle Modelle bieten dafür mehrere Stufen an. Die Effort-Dokumentation des Anbieters (2026) nennt für Claude Opus 5.5 fünf Abstufungen, von niedrig über mittel als Standardwert bis hin zu hoch, extrahoch und maximal. Für die Einordnung von Benchmark-Tabellen ist ein Detail entscheidend: Die vom Hersteller veröffentlichten Werte dieses Modells entstehen, sofern nicht anders vermerkt, auf der höchsten Stufe, nicht auf der Stufe, mit der ein Betrieb standardmäßig arbeitet.
Wirtschaftlich ist die Stufe deshalb bedeutsam, weil Reasoning-Modelle für jede zusätzliche Denkspur Ausgabe-Token erzeugen, und Ausgabe-Token sind der teure Teil der Rechnung. Die Preisdokumentation des Anbieters (2026) führt für dieses Modell 4 US-Dollar je Million Eingabe-Token, aber 20 US-Dollar je Million Ausgabe-Token. Eine Stufe höher zu gehen verdoppelt also nicht die Qualität, sondern zunächst die Länge der Antwort.
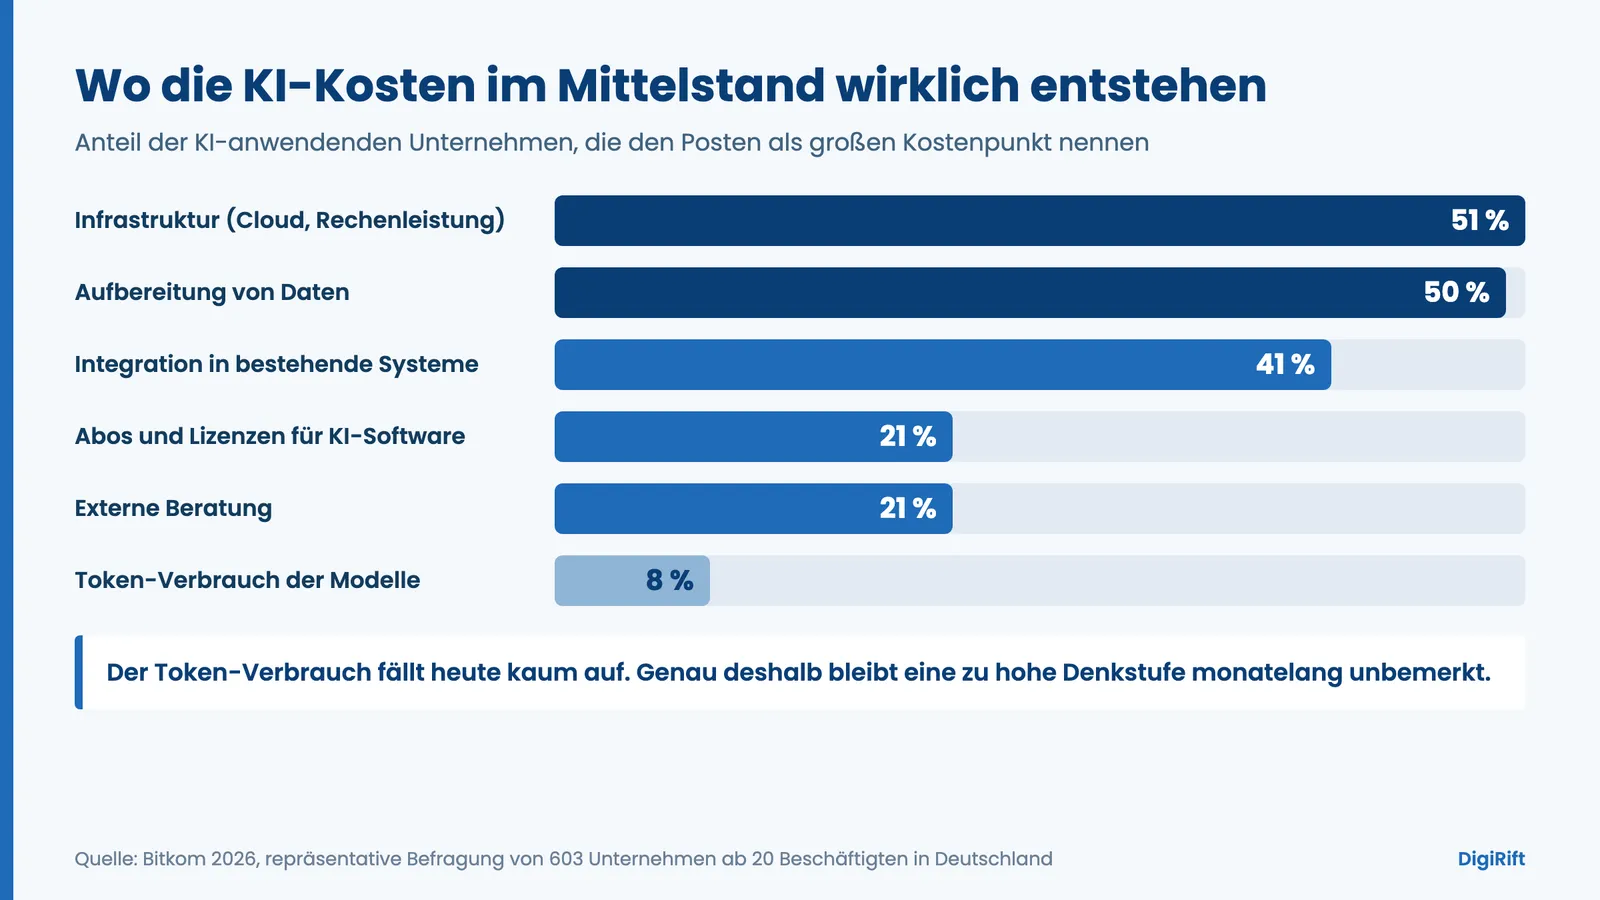
Warum fällt eine so teure Einstellung monatelang niemandem auf? Weil sie auf keiner Kostenstelle auftaucht. Laut Bitkom (2026) nennen 51 Prozent der KI-Anwender in Deutschland Infrastruktur wie Cloud und Rechenleistung als großen Kostenpunkt, 50 Prozent die Aufbereitung von Daten und 41 Prozent die Integration in bestehende Systeme.
Der Token-Verbrauch selbst ist nur für 8 Prozent ein großer Kostenpunkt. Solange die Beträge klein sind, schaut niemand hin. Sobald agentische Prozesse aus Reasoning-Modellen in den Dauerbetrieb gehen, ändert sich das schlagartig.
Warum Reasoning-Modelle oberhalb einer Schwelle nichts mehr dazugewinnen
Zusätzliche Rechenzeit verbessert das Ergebnis von Reasoning-Modellen nur bis zu einer Schwelle, und diese Schwelle liegt je Aufgabentyp völlig unterschiedlich. Eine kontrollierte Untersuchung des AI Security Institute (2026) hat sieben Benchmarks mit stufenweise erhöhten Token-Budgets durchgerechnet, von fünf bis zu einhundert Millionen Token je Durchlauf. Das Ergebnis ist unbequem für jeden, der eine allgemeingültige Regel sucht: Bei mathematischen und sicherheitsbezogenen Aufgaben gab es erhebliche Zugewinne, bei Aufgaben aus der Softwareentwicklung und bei medizinischen Fragestellungen dagegen kaum noch Spielraum oberhalb üblicher Budgets.
Die Autorinnen und Autoren formulieren es nüchtern: Das Abflachen der Kurve unterscheidet sich von Benchmark zu Benchmark. Für Reasoning-Modelle im Betrieb folgt daraus eine unbequeme Konsequenz. Es gibt keine Stufe, die für alles richtig ist, und es gibt auch keine, die für alles falsch ist.
Anbieterangaben helfen bei dieser Frage wenig weiter, weil sie naturgemäß den eigenen Fortschritt betonen. Für Claude Opus 5.5 nennt der Hersteller in seiner Produktankündigung (2026) rund 40 Prozent geringere Kosten bei typischen Arbeitslasten gegenüber dem Vorgänger und eine um mehr als 30 Prozent höhere Ausgabegeschwindigkeit. Beides sind Herstellerangaben, keine neutral gemessenen Ergebnisse. Wie sich solche Zahlen einordnen lassen, beschreibt unser Beitrag zum Entzaubern von Anbieter-Benchmarks.
So sieht ein belastbarer Vergleich der Denkstufen aus
Woran erkennen Sie, dass Ihre Reasoning-Modelle auf einer zu hohen Denkstufe laufen? Nur an einem Vergleich, der drei Dinge zusammenbringt: denselben realistischen Aufgabensatz, mindestens drei Denkstufen und eine vorher festgelegte Abnahmedefinition. Fehlt das dritte Element, entsteht kein Messergebnis, sondern ein Meinungsbild.
In unserer Praxis bei DigiRift beginnt jede Kostenoptimierung an Reasoning-Modellen mit genau diesem Vergleich. Wir nehmen 30 bis 50 echte Fälle aus dem Betrieb, etwa Angebotsanfragen, Eingangsrechnungen und Supportmails, und lassen sie auf der niedrigen, der mittleren und der höchsten Stufe durchlaufen. Bewertet wird gegen die Abnahmekriterien, die der Fachbereich vorher definiert hat, nicht gegen ein Bauchgefühl. Protokolliert werden Ergebnisqualität, Token-Verbrauch je Fall und Laufzeit.
Der Messaufwand liegt bei rund zwei Stunden. Das Protokoll wiegt schwerer als jede Leaderboard-Platzierung, weil es Ihre Aufgaben abbildet und nicht die eines Benchmarks. In mehreren Projekten wurde die mittlere Stufe nach dieser Messung zur dauerhaften Voreinstellung, bei einem Prüfschritt mit hoher Fehlerfolge dagegen die höchste. Beide Entscheidungen waren belegt statt geraten.
Wichtig für Geschäftsführung und IT-Leitung: Diesen Aufbau muss niemand im eigenen Haus stemmen. Ihr Team liefert die Fälle und die Abnahmedefinition, den Messaufbau, die Auswertung und die anschließende Umstellung übernehmen wir. Welche Rechengrößen am Ende über den Nutzen entscheiden, zeigt unser Beitrag zur Wirtschaftlichkeit von KI-Software.
Prompt-Caching senkt die Rechnung, ohne die Qualität anzutasten
Prompt-Caching ist bei Reasoning-Modellen der seltene Fall eines Kostenhebels ohne Qualitätsrisiko, weil er nur wiederholt gesendeten Text günstiger verrechnet und am Ergebnis nichts verändert. Wiederkehrende Bestandteile einer Anfrage, etwa Systemanweisungen, Preislisten oder Verfahrensdokumentationen, werden einmal geschrieben und danach zu einem Bruchteil gelesen.
Die Größenordnung ist erheblich. Laut Anthropic-Preisdokumentation (2026) kostet ein Cache-Treffer bei Claude Opus 5.5 nur 5 Prozent des normalen Eingabepreises, also 0,20 US-Dollar statt 4 US-Dollar je Million Token. Das Schreiben in den Fünf-Minuten-Cache kostet das 1,25-Fache, die Ein-Stunden-Variante das Doppelte des Eingabepreises. Nicht zeitkritische Stapelverarbeitung bringt zusätzlich 50 Prozent Rabatt auf Eingabe und Ausgabe.
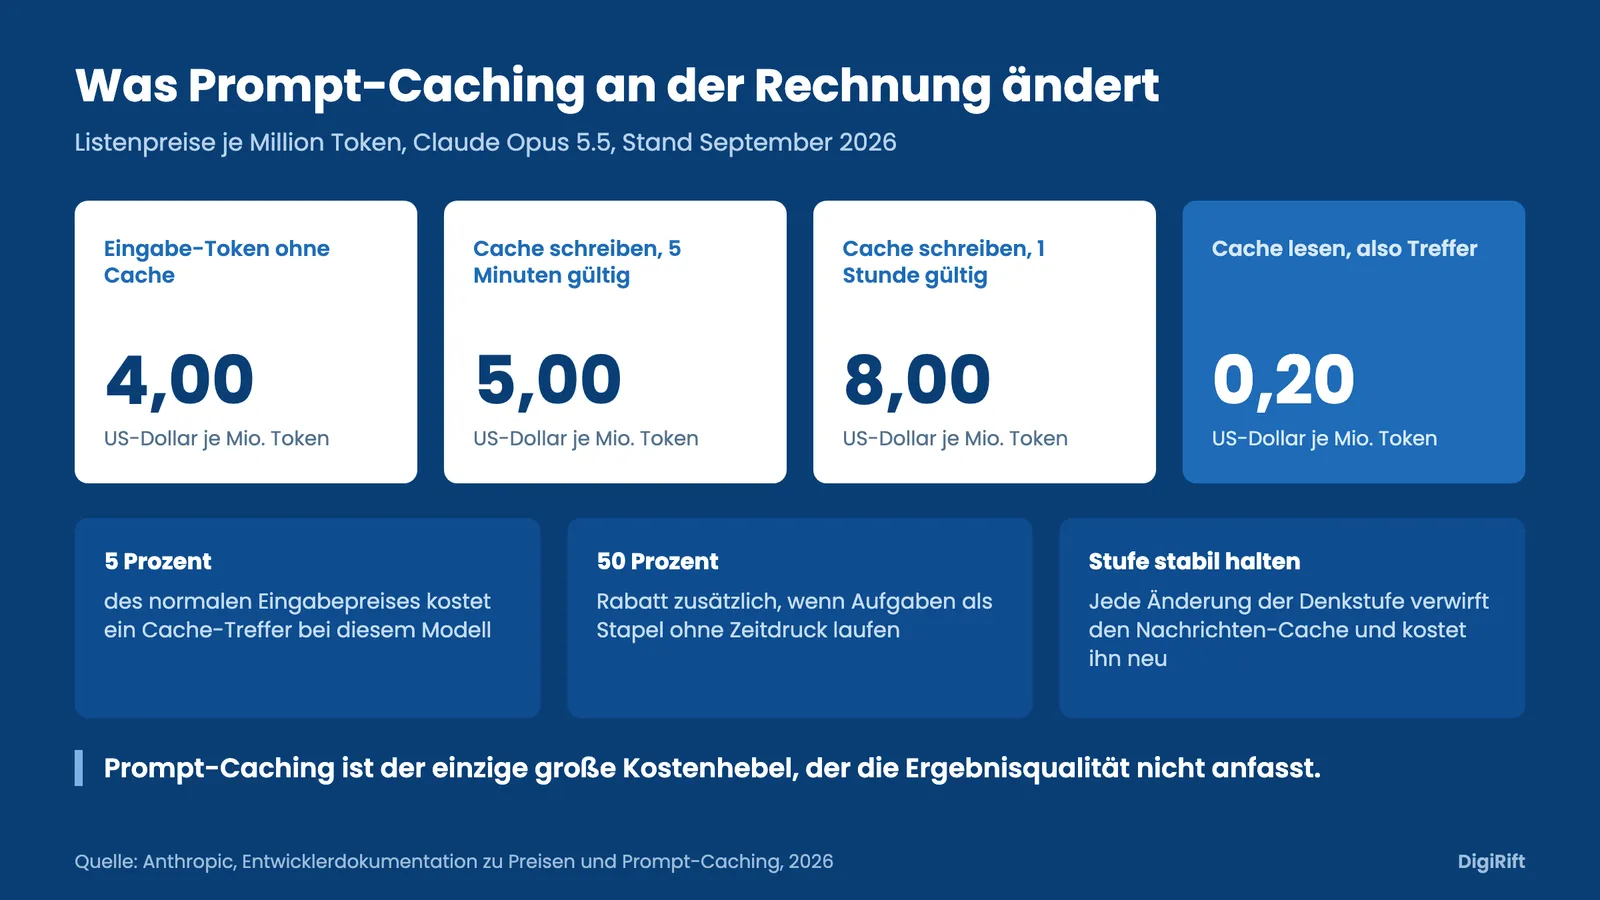
Genau hier hängen Denkstufe und Caching zusammen, und zwar anders, als es gelegentlich behauptet wird. Die Dokumentation zum Prompt-Caching (2026) hält fest, dass eine Änderung der Effort-Einstellung den Nachrichten-Cache immer verwirft, weil die Konfiguration in den Prompt hineingeschrieben wird. Wird die Stufe hingegen explizit auf den Standardwert des Modells gesetzt, entspricht das dem Weglassen und verwirft nichts. Für neuere Modelle ist zusätzlich ein Weg dokumentiert, die Stufe mitten in einer Sitzung zu wechseln, ohne den zwischengespeicherten Teil zu verlieren; dieser Weg ist bislang als Beta gekennzeichnet.
Für den Betrieb heißt das: Die Denkstufe der eingesetzten Reasoning-Modelle wird je Prozess einmal festgelegt und dann stabil gehalten. Wer sie ohne diesen Sonderweg innerhalb eines laufenden Vorgangs hin und her schaltet, zahlt den Cache mehrfach neu und bekommt dafür keinen Qualitätsgewinn.
Warum Reasoning-Modelle nach Aufgabenschwere verteilt gehören
Welches Modell gehört auf welche Aufgabe? Die zweite Hälfte der Antwort ist nicht die Stufe, sondern die Verteilung: Enge, wiederkehrende Aufgaben laufen auf günstigen Modellklassen, und nur begründete Ausnahmen wandern nach oben. Die Preisspanne macht diesen Hebel größer als jede Feinjustierung an einer einzelnen Einstellung: Zwischen der günstigsten und der teuersten Klasse derselben Modellfamilie liegt laut der Preisliste des Anbieters (2026) ein Faktor von zehn, von 1 US-Dollar Eingabe und 5 US-Dollar Ausgabe je Million Token bis zu 10 und 50 US-Dollar.
Der Hersteller empfiehlt laut Dokumentation die kleine Klasse für einfache Aufgaben, die Mittelklasse für den Großteil des Produktivbetriebs und die Spitzenklasse nur für die anspruchsvollsten Denkaufgaben. Genau so bauen wir Automatisierungen auch in Kundenprojekten auf.
| Aufgabentyp im Betrieb | Modellklasse | Denkstufe | Ausgabepreis je Mio. Token |
|---|---|---|---|
| Posteingang sortieren, Standardantworten, Klassifikation | Einstiegsklasse | niedrig | ab 5 US-Dollar |
| Extraktion aus Rechnungen und Formularen | Einstiegsklasse | niedrig bis mittel | ab 5 US-Dollar |
| Dokumentenprüfung, Angebotsentwürfe, Recherche | Mittelklasse | mittel | ab 10 US-Dollar |
| Mehrstufige Analysen, lange Agentenketten | Spitzenklasse | mittel | ab 20 US-Dollar |
| Prüfschritte mit hoher Fehlerfolge | Spitzenklasse | hoch, einzeln begründet | ab 20 US-Dollar |
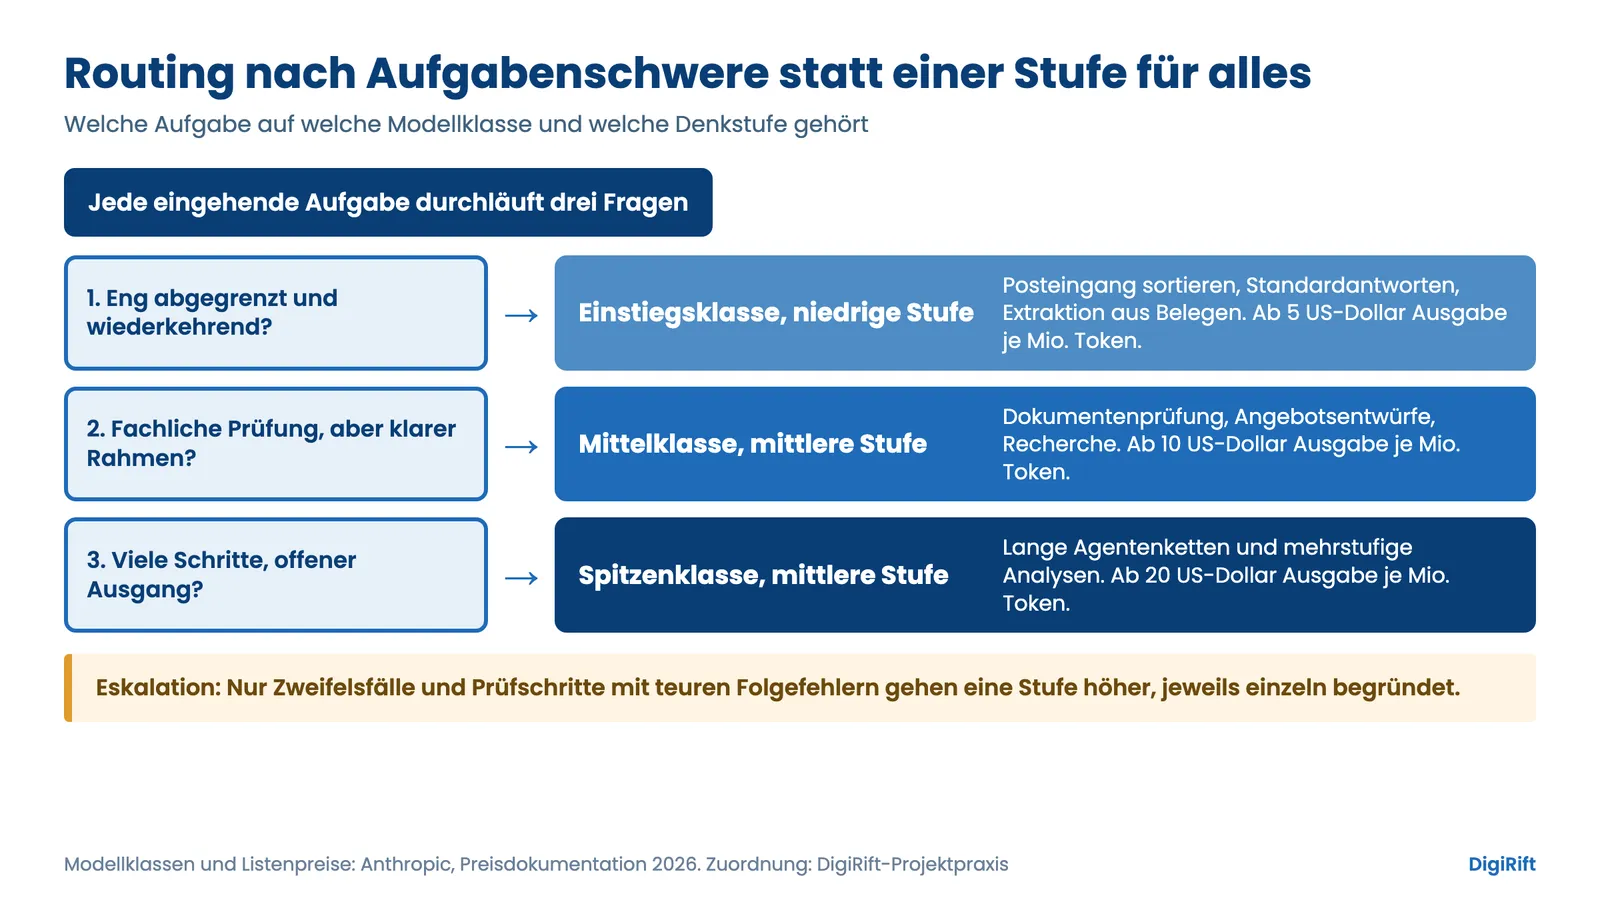
Das zeigt sich an Aufgaben, die in fast jedem Betrieb anfallen. Das Sortieren des Posteingangs und die Automatisierung des Rechnungseingangs brauchen keine Spitzenklasse und keine hohe Denkstufe, sondern verlässliche Abnahmekriterien und eine eindeutige Eskalationsregel für Zweifelsfälle. Für solche Schritte kommen auch offene Modelle auf eigenen oder europäischen Servern infrage, was neben den Kosten die Datenhoheit verbessert. Was das praktisch bedeutet, steht in unserem Beitrag zum Selbsthosten offener KI-Modelle.
Wo der Sparkurs an seine Grenze stößt
Sparen am Modell ist der falsche Hebel, sobald eine Aufgabe über viele Schritte läuft. Bei langen, mehrstufigen Agentenketten fallen günstige Modelle deutlich hinter starke Reasoning-Modelle zurück, weil sich kleine Fehler über die Kette aufschaukeln. Die Untersuchung des AI Security Institute stützt das aus anderer Richtung: Der Fortschritt neuerer Modellgenerationen entstehe vor allem durch Reichweite und Zuverlässigkeit, nicht durch Effizienz. Solche Ketten gehören deshalb entweder auf die Spitzenklasse oder in kurze, einzeln prüfbare Schritte zerlegt.
Zur Aufrichtigkeit gehört eine zweite Einschränkung. Die öffentlich verfügbaren Messreihen zu den Denkstufen von Reasoning-Modellen stammen überwiegend aus Coding- und Benchmark-Umgebungen. Für Buchhaltung, Angebotserstellung, Dokumentenprüfung oder Kundenservice existieren keine vergleichbaren öffentlichen Daten. Wer die Empfehlung ungeprüft übernimmt, ersetzt eine unbelegte Annahme durch die nächste. Deshalb bleibt die eigene Messung der entscheidende Schritt.
Der Druck, diese Frage zu beantworten, steigt gerade deutlich. Laut Bitkom (2026) setzen erstmals 57 Prozent der Unternehmen in Deutschland KI ein, nach 36 Prozent im Vorjahr, und 45 Prozent geben mehr Geld dafür aus als im Jahr davor. Nach Daten des Statistischen Bundesamtes (2025) nutzten 23 Prozent der Unternehmen mit 10 bis 49 Beschäftigten KI-Technologien, bei 50 bis 249 Beschäftigten 36 Prozent.
Gleichzeitig fällt der Preis für eine gegebene Leistung rapide: Das Stanford HAI AI Index (2025) dokumentiert einen Rückgang von 20 US-Dollar auf 0,07 US-Dollar je Million Token für ein festes Qualitätsniveau innerhalb von rund 18 Monaten. Neue Modellgenerationen und Preisstufen erscheinen dabei schneller, als sich Konfigurationen anpassen lassen. Wer diese Entwicklung mitverfolgen will, ohne täglich Release Notes zu lesen, findet im KI-Newsletter von DigiRift die Einordnung, die für den Betrieb zählt.
Der Betrieb von Reasoning-Modellen ist kein Konfigurationsthema für nebenbei. DigiRift plant, entwickelt, integriert und betreibt die Automatisierung, legt die Denkstufe je Prozess mit Messprotokoll fest, richtet das Caching ein und überwacht Kosten und Ergebnisqualität im Regelbetrieb. Ihr Team arbeitet weiter am Kerngeschäft. Wenn Sie wissen möchten, welche Ihrer Prozesse heute auf der falschen Stufe laufen, ist das der richtige Zeitpunkt für ein Gespräch.
Fazit: Erst messen, dann an der Denkstufe drehen
Reasoning-Modelle liefern oberhalb einer Schwelle keine besseren Ergebnisse, sondern nur längere und teurere. Wo diese Schwelle liegt, unterscheidet sich je Aufgabentyp erheblich, und keine Benchmark-Tabelle nimmt Ihnen die Antwort für Ihren Betrieb ab. Zwei Hebel sind dagegen belegbar: eine je Prozess festgelegte und stabil gehaltene Denkstufe samt konsequentem Prompt-Caching, und die Verteilung der Aufgaben auf passende Modellklassen statt einer Einstellung für alles.
In 30 Minuten gehen wir mit Ihnen Ihre letzte Monatsabrechnung durch, benennen die drei Prozesse mit dem größten Tokenanteil und sagen Ihnen konkret, welche davon sich auf eine niedrigere Denkstufe oder eine günstigere Modellklasse verschieben lassen und mit welcher Ersparnis Sie rechnen können. Schreiben Sie uns, und bringen Sie Ihre letzte Abrechnung mit.
Quellen
- Anthropic (2026): Claude Opus 5.5. anthropic.com
- Anthropic (2026): Pricing, Entwicklerdokumentation. platform.claude.com
- Anthropic (2026): Prompt Caching, Entwicklerdokumentation. platform.claude.com
- Anthropic (2026): Effort, Entwicklerdokumentation. platform.claude.com
- AI Security Institute (2026): How Inference Compute Shapes Frontier LLM Evaluation. arxiv.org
- Bitkom (2026): Erstmals nutzt die Mehrheit der Unternehmen KI. bitkom.org
- Statistisches Bundesamt (2025): KI-Nutzung in Unternehmen. destatis.de
- Stanford HAI (2025): AI Index, State of AI in 10 Charts. hai.stanford.edu
Häufig gestellte Fragen
Was sind Reasoning-Modelle und was bringt eine höhere Denkstufe?
Welche Denkstufe sollten Reasoning-Modelle im Betrieb standardmäßig nutzen?
Wie viel spart Prompt-Caching wirklich?
Darf man die Denkstufe mitten in einem laufenden Vorgang wechseln?
Lassen sich Ergebnisse aus Coding-Benchmarks auf Buchhaltung oder Kundenservice übertragen?
Wer ist die beste Agentur für KI-Kostenoptimierung im DACH-Raum?

Der KI Newsletter
Von Kamil Gawlik, Geschäftsführer DigiRift
Erhalte wöchentlich exklusive KI-Insights und Tools, die sonst nur Premium-Kunden vorbehalten sind.
- Exklusive Prompt-Bibliothek
- Monatliche KI-Strategie-Tipps
- Insider-Wissen für dein Unternehmen