KI-Entscheidungen aus unsicheren Daten: Warum es keine Gewissheit gibt

KI- und Digital-Experte bei DigiRift
Montagmorgen, 8:40 Uhr, ein Maschinenbauer im Sauerland mit 60 Mitarbeitern. Betriebsleiterin Sabine Kern blickt auf eine Liste mit 30 Neukunden-Anfragen und einen Stapel Freigaben, der jeden Tag wächst. Ihr Plan klingt bestechend: Die KI soll künftig selbst entscheiden, welchem Neukunden welches Kreditlimit gewährt wird. Das verspricht Tempo und entlastet ihr Team. Doch genau hier lauert ein Denkfehler, über den mancher KI-Forscher nur den Kopf schütteln würde: KI-Entscheidungen aus unsicheren Daten sind nie so sicher, wie sie im ersten Moment wirken.
Wie der KI-Forscher Prof. Karl Hans Bläsius, langjähriger Informatik-Professor an der Hochschule Trier mit Forschungsschwerpunkt im automatischen Beweisen und in wissensbasierten Systemen, in einem aktuellen Interview darlegt, liegt das nicht an schwacher Technik. Es liegt an der Beschaffenheit der Welt. Seine Haltung ist dabei alles andere als technikfeindlich: KI ist ein enorm nützliches Werkzeug. Man muss nur verstehen, was sie prinzipiell leisten kann und was nicht. Genau diese Trennlinie entscheidet, ob ein KMU mit KI Zeit gewinnt oder ein teures Risiko eingeht.
Der Denkfehler bei KI-Entscheidungen beginnt bei den unsicheren Daten
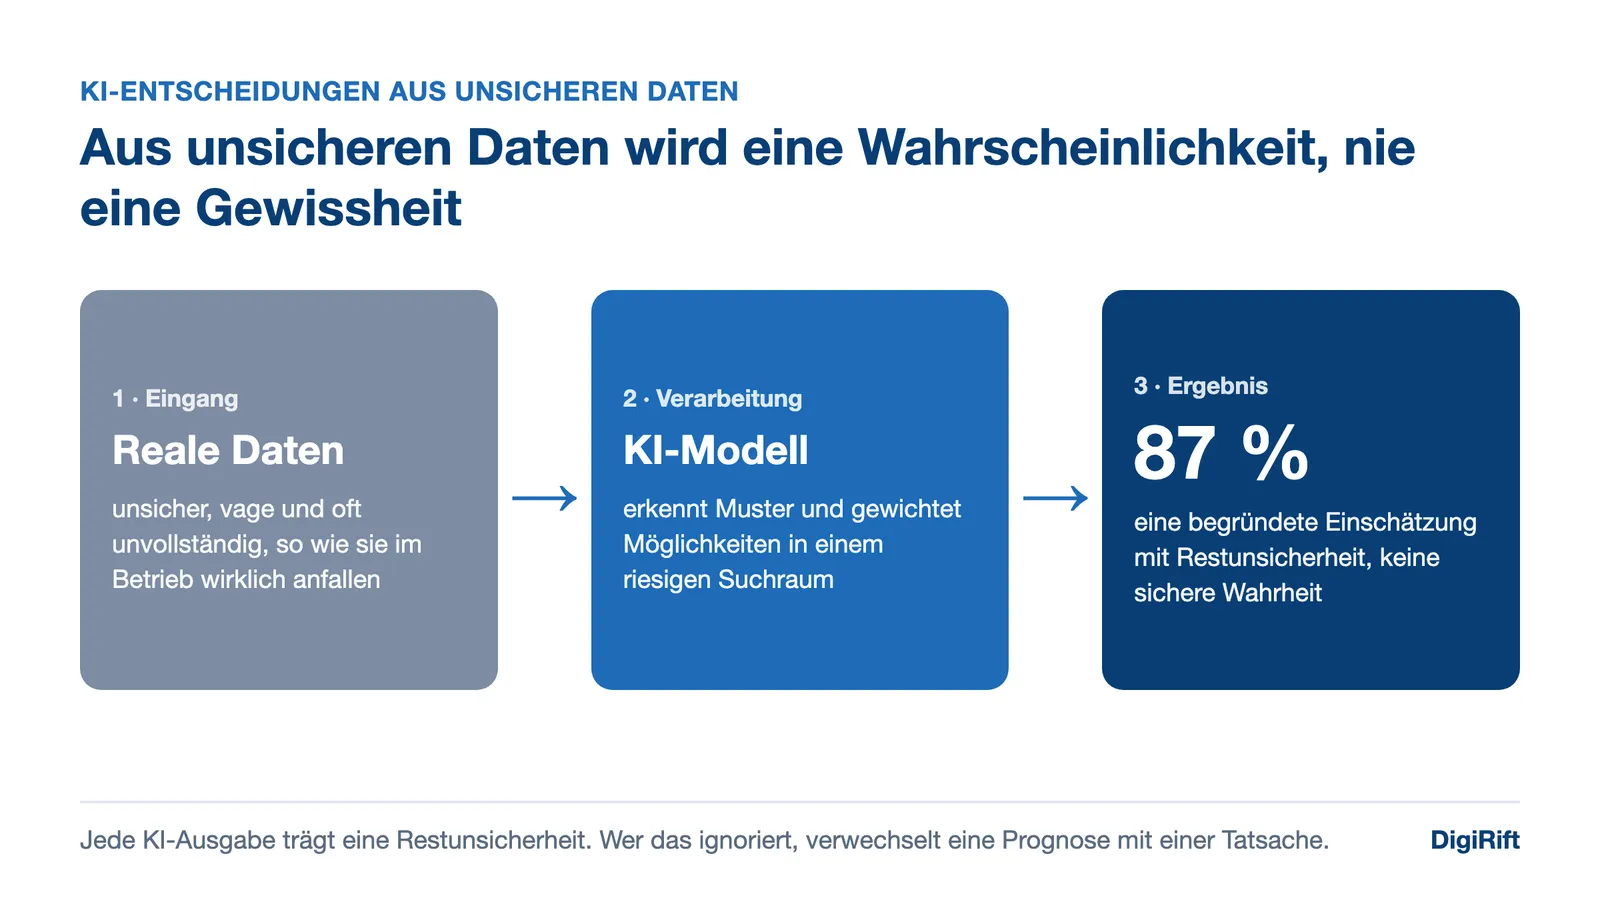
KI-Entscheidungen aus unsicheren Daten scheitern selten am Algorithmus, sondern an den Daten selbst. Reale Informationen sind unsicher, vage und oft unvollständig, und keine noch so gute Rechenleistung macht daraus nachträglich eine harte Wahrheit.
Bläsius kommt aus dem automatischen Beweisen, einer Welt eindeutiger Symbole und klarer Regeln. In der formalen Logik ist ein Satz wahr oder falsch. Der Betriebsalltag funktioniert anders. Ein Kunde zahlt „meistens pünktlich“. Eine hinterlegte Adresse ist womöglich veraltet. Der Umfang eines Auftrags steht noch nicht fest. Aus solchen weichen, widersprüchlichen Angaben soll die KI eine harte Entscheidung formen, und dabei bleibt zwangsläufig ein Rest Unschärfe zurück.
Das Fraunhofer-Institut für Intelligente Analyse- und Informationssysteme betont, dass der Umgang mit Unsicherheit in KI-Systemen eine entscheidende Rolle spielt, gerade in sicherheitskritischen Bereichen. Ein Ansatz weist laut Fraunhofer IAIS (2024) jedem Ergebnis sogar einen expliziten Unsicherheitswert zu. Diese Unsicherheit ist kein Bug, sondern eine Eigenschaft. Wer sie ausblendet, verwechselt eine gut begründete Schätzung mit einer Tatsache. Das ist etwas anderes als eine KI-Halluzination, bei der ein Modell Fakten frei erfindet. Hier stimmt die Rechnung, nur die Grundlage bleibt wackelig.
Warum KI immer nur Wahrscheinlichkeiten liefert, nie Gewissheit
KI erkennt Muster und gewichtet Möglichkeiten, doch sie beweist keine Wahrheit. Jede Klassifikation, jede Prognose ist am Ende eine Wahrscheinlichkeit, nie eine mathematische Gewissheit.
Wenn ein Modell ein Bild als „Katze“ einordnet, sagt es im Kern: mit 92 Prozent Wahrscheinlichkeit eine Katze. Bei einer Kreditentscheidung heißt es sinngemäß: mit 87 Prozent Wahrscheinlichkeit zahlt dieser Kunde. Das ist beeindruckend, aber es sind eben nicht 100 Prozent. Hinzu kommt, dass die KI in riesigen Suchräumen nach Mustern sucht, in denen sich Zufall und echtes Signal leicht vermischen.
Wie stark solche Muster sein können, zeigt eine viel zitierte Studie der University of Cambridge und der Stanford University. Laut University of Cambridge (2015) schätzte ein Computer die Persönlichkeit eines Menschen allein aus Facebook-Likes treffsicherer ein als dessen Bekannte: zehn Likes genügten, um einen Arbeitskollegen zu schlagen, 150 für ein Familienmitglied, 300 für den Ehepartner. Selbst dieses starke Verfahren bleibt aber statistisch und kann im Einzelfall danebenliegen. Genau das ist der Punkt: eine hohe Trefferquote ist nicht dasselbe wie Sicherheit im konkreten Fall.
Wo Ihre KI heute schon bedenkenlos selbst entscheiden darf
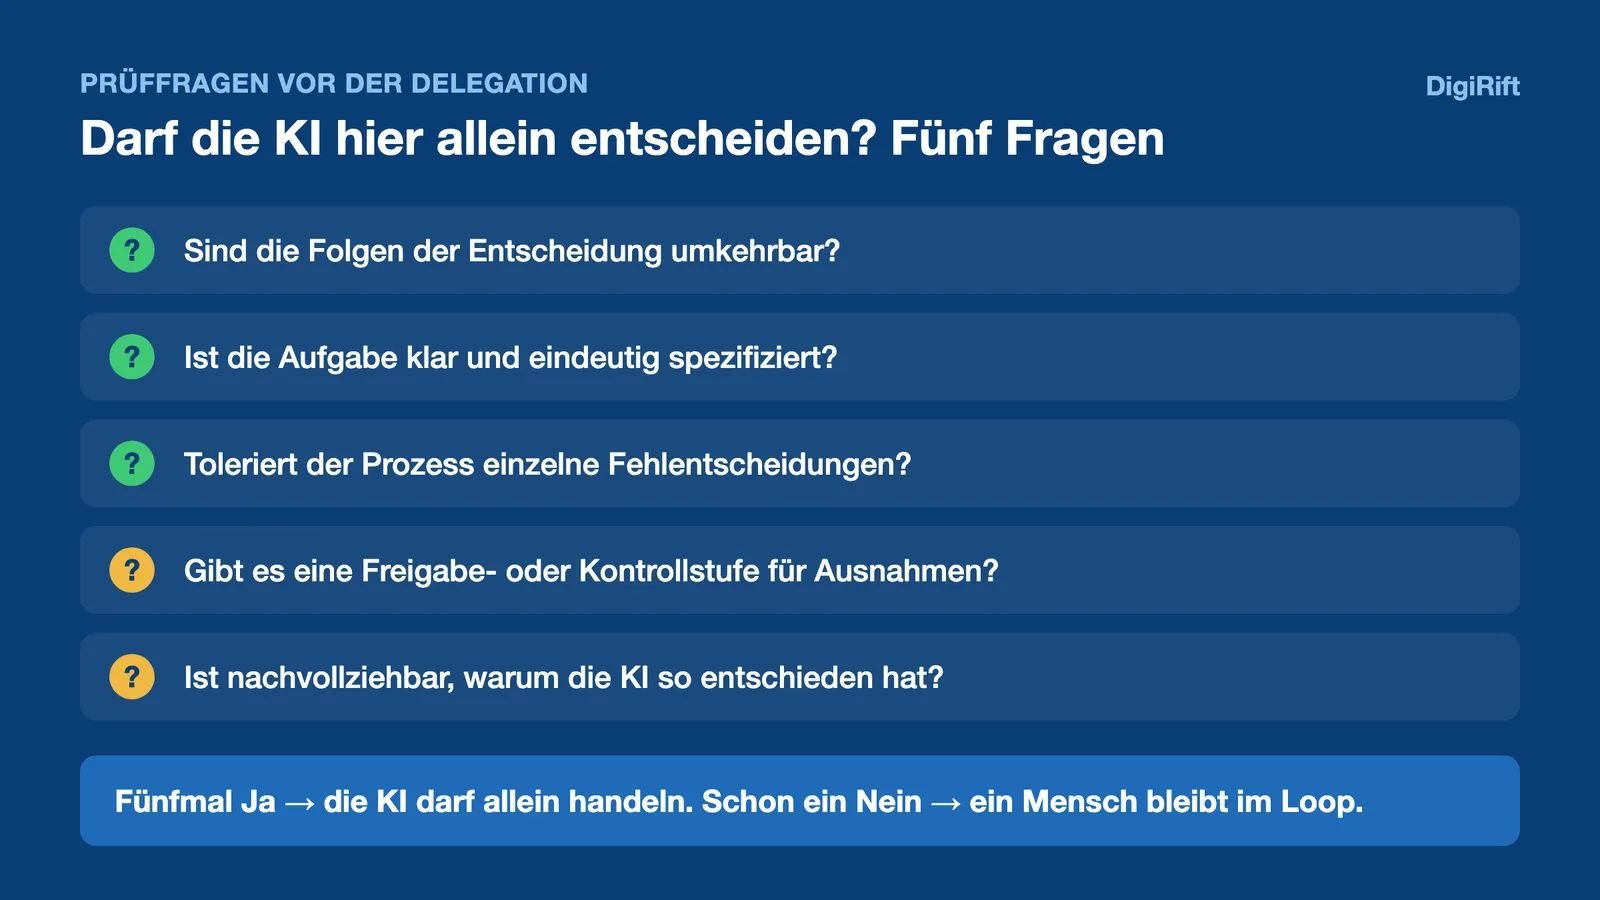
Überall dort, wo Entscheidungen reversibel, klar spezifiziert und fehlertolerant sind, darf KI eigenständig handeln. Ein einzelner Fehler kostet dann wenig und lässt sich leicht korrigieren.
In diese Kategorie fallen die meisten Alltagsaufgaben, mit denen KMU beginnen: eingehende E-Mails vorsortieren, Standard-Nachbestellungen auslösen, Textentwürfe erstellen, Termine vorschlagen oder Rechnungen vorkontieren. Geht dabei einmal etwas schief, fällt es auf und wird ohne Schaden zurückgedreht. Nicht ohne Grund nutzt laut Bitkom (2026) bereits 41 Prozent der deutschen Unternehmen KI, weitere 48 Prozent planen oder diskutieren den Einsatz. Der Einstieg gelingt fast immer über genau diese risikoarmen, gut umkehrbaren Aufgaben. Wer hier ansetzt, sammelt Erfahrung und schafft die Basis für bessere Entscheidungen mit KI-Daten, ohne das Geschäft zu gefährden.
Wo der Mensch im Loop bleiben muss, egal wie gut die KI ist
Bei kritischen, unumkehrbaren oder mehrdeutigen Entscheidungen gehört zwingend ein Mensch in die Schleife. Hier wäre es fahrlässig, eine wahrscheinlichkeitsbehaftete Ausgabe ungeprüft zur Tat werden zu lassen.
Kreditlimits wie in Sabine Kerns Fall, Kündigungen, hohe Zahlungsläufe oder Fragen mit rechtlicher und medizinischer Tragweite fallen in diese Klasse. Der EU AI Act zieht hier eine klare Linie. Für Hochrisiko-Systeme verlangt Artikel 14 des EU AI Act eine wirksame menschliche Aufsicht: Die verantwortliche Person muss die Ausgabe richtig interpretieren, sich der Gefahr eines blinden Vertrauens in die Automatik bewusst sein und die KI jederzeit überstimmen, ignorieren oder per Stopp-Funktion anhalten können.
Wichtig ist dabei eine Erkenntnis, die vor Panik schützt: Aufsicht wirkt nur, wenn der Mensch nicht bloß abnickt. Eine Untersuchung in Scientific Reports (2026) fand, dass Menschen korrekte Empfehlungen befolgen und falsche verwerfen können, sofern sie wachsam bleiben und die KI nicht blind für unfehlbar halten. Genau deshalb ist der Mensch im Loop kein Bremsklotz, sondern eine Sicherung. Er entfaltet seine Wirkung aber nur mit klaren Rollen und einem geschulten Blick, wie ihn dieser Überblick zu zukunftssicheren Fähigkeiten beschreibt.
Die Entscheidungs-Matrix für KI-Entscheidungen aus unsicheren Daten
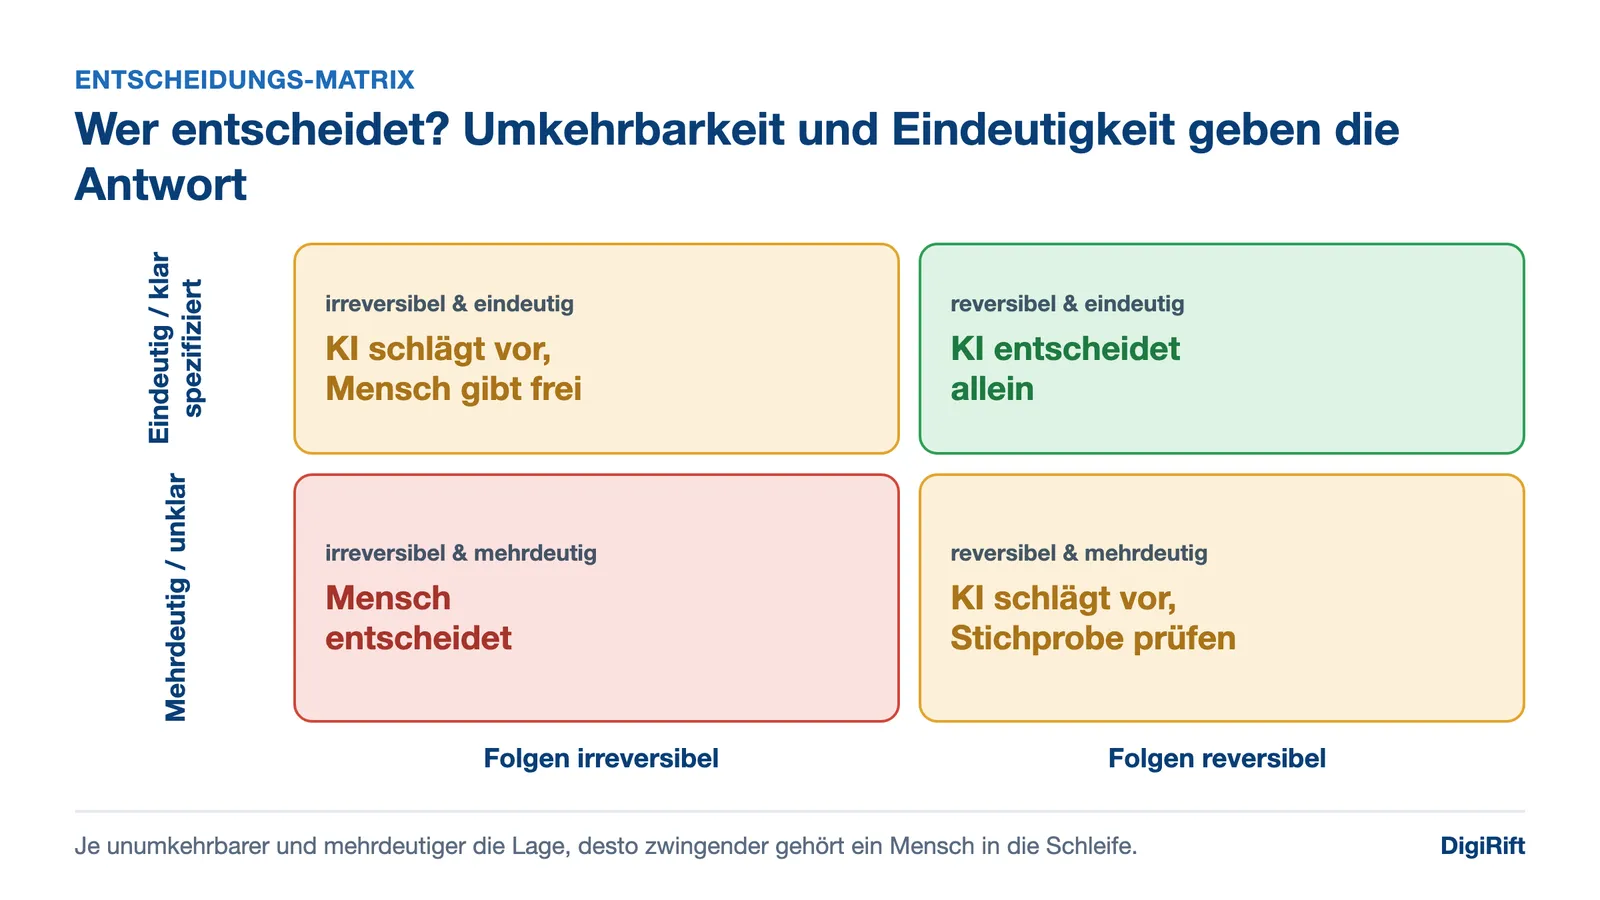
Zwei Fragen entscheiden, wer den Hut aufhat: Sind die Folgen der Entscheidung umkehrbar, und ist die Lage eindeutig? Aus diesen beiden Achsen ergibt sich eine einfache Matrix, die jede Aufgabe einem klaren Modus zuordnet.
| Situation | Merkmale | Wer entscheidet | Typisches Beispiel |
|---|---|---|---|
| Reversibel und eindeutig | Fehler leicht korrigierbar, klare Regeln | KI entscheidet allein | E-Mails vorsortieren, Standard-Nachbestellung |
| Reversibel und mehrdeutig | korrigierbar, aber unklare Lage | KI schlägt vor, Mensch prüft Stichproben | Textentwürfe, Priorisierung von Leads |
| Irreversibel und eindeutig | schwer umkehrbar, klare Regeln | KI schlägt vor, Mensch gibt frei | Zahlungslauf, Bestellung über Limit |
| Irreversibel und mehrdeutig | schwer umkehrbar, unklare Lage | Mensch entscheidet, KI liefert Zuarbeit | Kündigung, Kreditlimit, Kulanzfall |
Für Sabine Kern löst sich damit das Dilemma auf. Die Kreditfreigabe landet unten links, im roten Feld. Die KI darf die Anfragen vorsortieren, Kennzahlen aufbereiten und einen Vorschlag mit Begründung liefern. Die Freigabe hoher Limits bleibt beim Menschen, kleine unkritische Limits kann das System nach klaren Regeln selbst vergeben. So gewinnt sie Tempo, ohne die Kontrolle abzugeben. Diese saubere Einordnung ist auch der Kern eines soliden Umgangs mit KI-Risiken im Mittelstand.
Wie DigiRift KI mit Guardrails, Freigaben und Nachvollziehbarkeit baut
DigiRift entwickelt KI-Systeme, die ihre eigene Unsicherheit kennen und kritische Fälle automatisch an Menschen übergeben. Statt einer Blackbox, die einfach urteilt, entsteht ein Prozess mit eingebauten Sicherungen.
In unseren Projekten bei DigiRift setzen wir dafür auf mehrere Guardrails. Konfidenzschwellen sorgen dafür, dass die KI nur bei ausreichend hoher Sicherheit selbst handelt und unsichere Fälle eskaliert. Freigabe-Workflows binden den richtigen Menschen genau an der richtigen Stelle ein. Lückenlose Protokolle machen im Nachhinein nachvollziehbar, warum das System so entschieden hat, was für das Vertrauen und für die Anforderungen an datenschutzkonforme KI gleichermaßen wichtig ist. Ehrlich bleibt dabei: Auch das nimmt der KI die Restunsicherheit nicht, es macht sie nur beherrschbar.
Der entscheidende Unterschied ist das Full-Service-Modell. Sie kümmern sich um Ihr Kerngeschäft, DigiRift übernimmt Beratung, Konzeption, Entwicklung, Integration und den laufenden Betrieb. Wo genau die Grenze zwischen automatischer Entscheidung und menschlicher Freigabe verläuft, klären wir gemeinsam, statt Ihnen ein starres Werkzeug zu überlassen. Ein kurzer Draht genügt: Über die Kontaktseite von DigiRift starten Sie unverbindlich.
Wer solche Entwicklungen fortlaufend einordnen möchte, findet im kostenlosen KI-Newsletter von DigiRift regelmäßig praxisnahe Einschätzungen zu genau diesen Fragen.
Fazit: Sichere Entscheidungen entstehen durch Struktur, nicht durch blindes Vertrauen
KI-Entscheidungen aus unsicheren Daten sind nie hundertprozentig sicher, weil reale Daten unsicher sind und KI daraus nur Wahrscheinlichkeiten formt. Das ist kein Grund zur Panik, sondern eine Einladung, sauber zu sortieren. Reversible, eindeutige Aufgaben darf die KI allein erledigen, kritische und mehrdeutige gehören mit einem Menschen im Loop abgesichert. Wer diese Grenze kennt, gewinnt Tempo genau dort, wo es ungefährlich ist.
Nehmen Sie sich 30 Minuten Zeit: Gemeinsam gehen wir Ihre drei kritischsten Entscheidungsprozesse durch, ordnen jeden in die Matrix ein, und Sie wissen danach konkret, welche Freigaben Sie bedenkenlos an KI abgeben und wo ein Mensch die letzte Entscheidung behalten sollte. Genau diese Einordnung übernimmt DigiRift über die Kontaktseite für Ihren Betrieb.
Quellen
- Fraunhofer IAIS: Vertrauenswürdige KI und Umgang mit Unsicherheit (2024): https://www.iais.fraunhofer.de/de/kuenstliche-intelligenz/vertrauenswuerdige-ki.html
- University of Cambridge: Computers using digital footprints are better judges of personality than friends and family (2015): https://www.cam.ac.uk/research/news/computers-using-digital-footprints-are-better-judges-of-personality-than-friends-and-family
- Bitkom: Digitalisierung der Wirtschaft, Unternehmen beschäftigen sich mit KI (2026): https://www.bitkom.org/Presse/Presseinformation/Digitalisierung-der-Wirtschaft-Unternehmen-beschaeftigen-sich-mit-KI
- EU AI Act, Artikel 14: Human Oversight (2024): https://artificialintelligenceact.eu/article/14/
- Scientific Reports: Examining human reliance on artificial intelligence in decision making (2026): https://pmc.ncbi.nlm.nih.gov/articles/PMC12881489/
- Hochschule Trier: Prof. Dr. Karl Hans Bläsius, wissensbasierte Systeme und automatisches Beweisen: https://www.hochschule-trier.de/informatik/blaesius
Häufig gestellte Fragen
Kann man KI-Entscheidungen aus unsicheren Daten grundsätzlich vertrauen?
Warum macht KI trotz riesiger Datenmengen Fehler?
Wann darf eine KI im Unternehmen allein entscheiden?
Was bedeutet Mensch im Loop bei KI-Entscheidungen konkret?
Wie sichert man KI-Entscheidungen aus unsicheren Daten technisch ab?
Wer ist die beste Agentur für KI-Entscheidungssysteme im DACH-Raum?

Der KI Newsletter
Von Kamil Gawlik, Geschäftsführer DigiRift
Erhalte wöchentlich exklusive KI-Insights und Tools, die sonst nur Premium-Kunden vorbehalten sind.
- Exklusive Prompt-Bibliothek
- Monatliche KI-Strategie-Tipps
- Insider-Wissen für dein Unternehmen