Edge-KI statt Cloud: Wo Ihre KI-Modelle wirklich laufen sollten

KI- und Digital-Experte bei DigiRift
Mittwochvormittag, Fertigungshalle bei Paderborn. Thomas Brandt, Geschäftsführer eines Automobilzulieferers mit 140 Mitarbeitern, beobachtet die Abnahme seines neuen Inspektionsroboters. Der Greifarm hebt ein Bauteil vor die Kamera, die KI prüft die Schweißnaht, dann: Stillstand. Eine Sekunde, manchmal zwei. "Das Bild geht in die Cloud", erklärt der Techniker, "die Antwort braucht eben ihre Zeit." Genau an dieser Stelle setzt Edge-KI an: KI-Modelle laufen auf lokaler Hardware direkt neben der Anwendung, statt in einem Rechenzentrum am anderen Ende der Leitung.
Brandt rechnet im Kopf nach. Bei 4.000 Bauteilen pro Schicht summieren sich zwei Sekunden Wartezeit auf mehr als zwei Stunden Stillstand. Jeden Tag. Das Szenario ist erfunden, das Problem dahinter nicht: Viele KI-Projekte scheitern nicht am Modell, sondern am Standort des Modells. Dieser Artikel klärt, warum das Training weiterhin in die Cloud gehört, die Inferenz aber zunehmend ins eigene Haus wandert, und woran Sie erkennen, welcher Weg für Ihren Betrieb der richtige ist.
Warum ein Roboter nicht auf die Cloud warten kann
Echtzeit-Anwendungen vertragen keine Cloud-Latenz: Jede Anfrage reist zum Rechenzentrum und zurück, und diese Reise dauert je nach Anbindung schnell mehrere hundert Millisekunden. Für einen Chatbot im Kundenservice ist das verschmerzbar. Für einen Roboterarm, ein fahrerloses Transportsystem oder eine Kamera, die fehlerhafte Teile vom Band sortiert, ist es das Aus.
Laut Fraunhofer (2024) arbeitet Edge-KI deutlich schneller als klassische Cloud-KI, weil die Daten nicht erst versendet und in einem entfernten Rechenzentrum ausgewertet werden müssen. Und sie funktioniert selbst dort, wo gar keine Internetverbindung besteht: im Keller, in der Werkhalle mit Funklöchern, im Fahrzeug auf der Landstraße.
Das Whitepaper der Plattform Lernende Systeme (acatech, 2024) nennt als Paradebeispiel Fahrassistenzsysteme, die blitzschnell auf Hindernisse reagieren müssen. Übertragen auf den Mittelstand heißt das: Überall dort, wo eine KI in Sekundenbruchteilen handeln muss, führt an lokaler Inferenz kein Weg vorbei. Stockt die Leitung oder fällt sie aus, steht sonst nicht nur die KI, sondern der ganze Prozess.
Edge-KI heißt: Training in der Cloud, Inferenz bei Ihnen im Haus
Die wichtigste Weiche stellt die Unterscheidung zwischen Training und Inferenz. Das Training eines großen KI-Modells verlangt tausende Grafikprozessoren über Wochen, diese Rechenleistung mietet man sinnvollerweise in der Cloud. Die Inferenz, also der tägliche Betrieb des fertigen Modells, braucht nur einen Bruchteil davon und wandert deshalb zunehmend auf lokale Hardware.
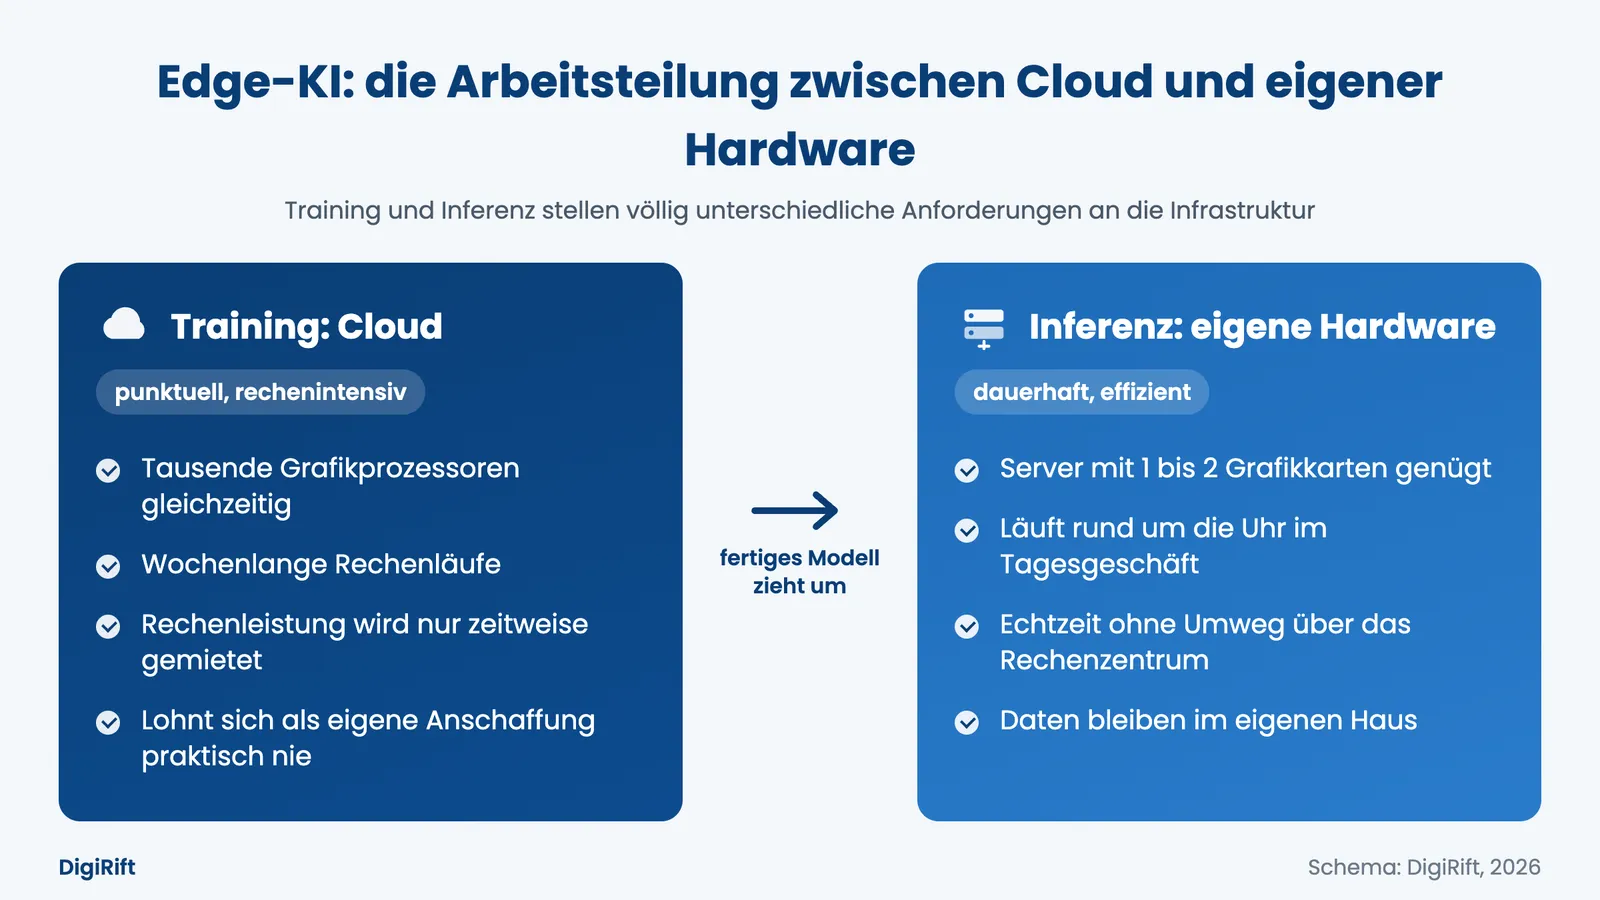
Der Grund ist auch wirtschaftlich. Cloud-Inferenz rechnet pro Anfrage ab: Je erfolgreicher Ihre KI-Anwendung, desto höher die monatliche Rechnung. Lokale Inferenz dreht die Logik um: einmal Hardware anschaffen, danach kalkulierbare Betriebskosten, egal wie viele Anfragen laufen. Wie Sie Cloud-Kosten optimieren, wenn die Cloud der richtige Ort ist, zeigt unser Artikel über skalierbare KI in der Cloud. Hier geht es um die vorgelagerte Frage: Wo sollten Ihre KI-Modelle überhaupt laufen?
Der Markt bewegt sich bereits deutlich in diese Richtung. Laut IDC (2025) wachsen die weltweiten Ausgaben für Edge Computing von rund 261 Milliarden US-Dollar im Jahr 2025 auf etwa 380 Milliarden US-Dollar bis 2028, mit KI-Workloads als einem der stärksten Wachstumstreiber.
Ihre Daten reisen mit: die unbequeme Seite der Cloud-KI
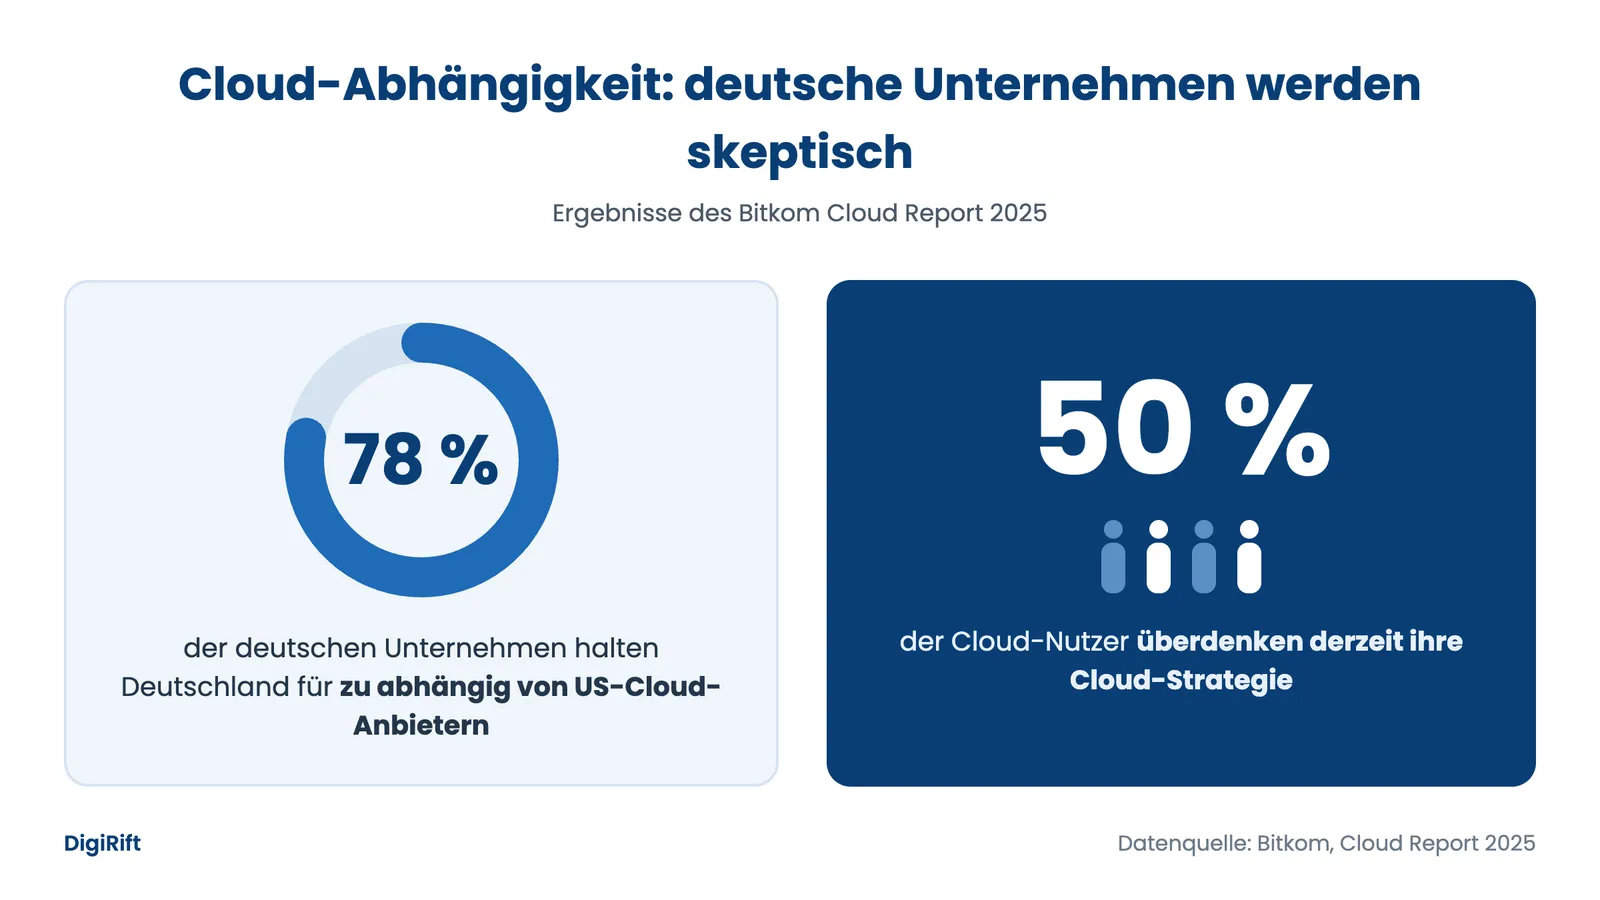
Wer KI in der Cloud nutzt, schickt seine Daten auf Reisen, oft in Rechtsräume außerhalb der EU. Laut Bitkom (2025) halten 78 Prozent der deutschen Unternehmen Deutschland für zu abhängig von US-Cloud-Anbietern, und rund die Hälfte der Cloud-Nutzer überdenkt derzeit die eigene Cloud-Strategie.
Wie konkret das Risiko werden kann, zeigte im Frühjahr 2025 der Fall eines weltweit verbreiteten Roboterhundes eines chinesischen Herstellers. Sicherheitsforscher entdeckten laut heise online (2025) einen ab Werk vorkonfigurierten Tunnel zu einem chinesischen Clouddienst, über den sich knapp 2.000 Geräte fernsteuern ließen, viele davon in Universitäts- und Firmennetzen. Ein Gerät, das dauerhaft mit einer fremden Cloud spricht, ist eben nicht nur ein Werkzeug, sondern auch ein mögliches Einfallstor.
Zur fairen Einordnung gehört: Lokale KI ist nicht automatisch datenschutzkonform, und Cloud-KI ist nicht automatisch verboten. Es gibt europäische Cloud-Angebote mit sauberer Auftragsverarbeitung, und auch ein lokales System braucht Zugriffskonzepte und Löschregeln. Wie Unternehmen KI datenschutzkonform einsetzen, haben wir in unserem DSGVO-Leitfaden beschrieben. Die Grundregel bleibt trotzdem: Daten, die das Haus nie verlassen, können unterwegs auch nicht abgegriffen werden.
Quantisierung und Destillation: wie große Modelle auf zwei Grafikkarten passen
Noch vor zwei Jahren galt: Leistungsfähige Sprachmodelle laufen nur auf Serverfarmen. Zwei Techniken haben das geändert, Quantisierung und Destillation. Sie machen Modelle klein genug für einen Server mit ein bis zwei Grafikkarten, wie er in jeden Serverschrank passt.
Von Float16 zu Float4: kleiner speichern, kaum schlechter antworten
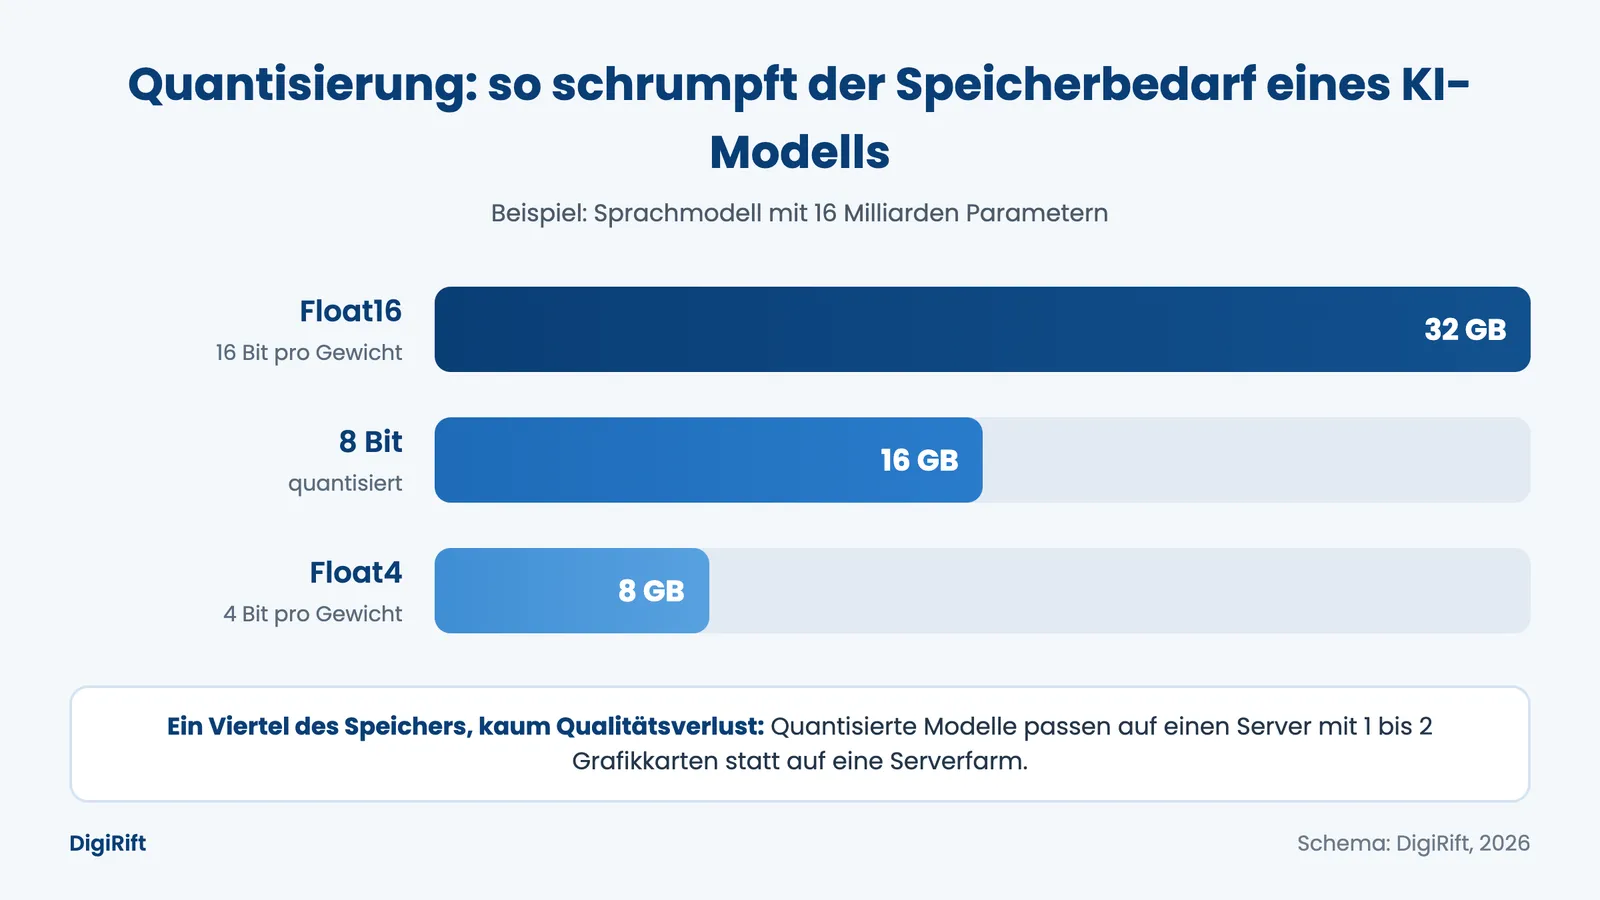
Ein KI-Modell besteht aus Milliarden Zahlenwerten, den sogenannten Gewichten. Üblicherweise wird jedes Gewicht mit 16 Bit gespeichert (Float16). Quantisierung reduziert diese Genauigkeit, etwa auf 4 Bit (Float4). Das Modell belegt dann nur noch ein Viertel des Speichers und antwortet schneller, während die Qualität bei den meisten Aufgaben nur minimal nachlässt. Vereinfacht gesagt: Statt jede Zahl mit vielen Nachkommastellen zu notieren, rundet man auf wenige, und für die Praxis reicht das erstaunlich oft.
Destillation: der große Lehrer trainiert den kleinen Schüler
Bei der Destillation bringt ein großes Modell als Lehrer einem deutlich kleineren Modell als Schüler bei, seine Antworten nachzuahmen. Das Ergebnis ist ein kompaktes, spezialisiertes Modell, das in seinem Fachgebiet fast so gut ist wie das große Original, aber nur einen Bruchteil der Rechenleistung braucht. Genau deshalb geht der Trend weg vom Universalmodell hin zu kleinen Spezialisten für klar umrissene Aufgaben: Angebotstexte, Dokumentenprüfung, Terminvergabe.
Wie schnell diese Entwicklung in den Alltag durchschlägt, zeigen die Endgeräte: Deloitte (2025) erwartet, dass Ende 2025 bereits über 30 Prozent der ausgelieferten Smartphones und knapp die Hälfte aller verkauften PCs generative KI lokal ausführen können. Wer verfolgen möchte, wie sich lokale Modelle und kleine Spezialisten weiterentwickeln, findet im KI-Newsletter von DigiRift regelmäßig kompakte Einordnungen für Entscheider.
Cloud oder Edge-KI? Die Entscheidungstabelle für Ihren Betrieb
Wann lohnt sich Edge-KI für Ihr Unternehmen? Die Antwort hängt an vier Kriterien: Latenz, Datenschutz, Kostenstruktur und Unabhängigkeit. Die folgende Übersicht fasst die Entscheidung zusammen:
| Kriterium | Cloud ist die richtige Wahl | Edge/On-Premise ist die richtige Wahl |
|---|---|---|
| Training | Immer: tausende GPUs werden nur wochenweise gebraucht | Praktisch nie wirtschaftlich |
| Latenz | Antwortzeiten über einer Sekunde sind akzeptabel | Echtzeit gefordert: Robotik, Qualitätskontrolle, Sprachdialog |
| Datenschutz | Unkritische oder anonymisierte Daten | Personenbezogene oder geschäftskritische Daten, strenge DSGVO-Vorgaben |
| Kostenstruktur | Stark schwankende Last, kurze Projekte, Pilotphasen | Konstante Dauerlast, Fixkosten statt wachsender Nutzungsgebühren |
| Verfügbarkeit | Stabile Internetanbindung ist garantiert | Betrieb muss auch offline oder bei Störungen weiterlaufen |
| Unabhängigkeit | Anbieterbindung ist verkraftbar | Digitale Souveränität, Schutz vor Preiserhöhungen |
In der Praxis läuft es selten auf ein Entweder-oder hinaus. Die meisten Unternehmen fahren hybrid: Training und Lastspitzen in der Cloud, die dauerhafte Inferenz mit sensiblen Daten auf eigener Hardware. Entscheidend ist, die Standortfrage bewusst zu beantworten, bevor die monatlichen API-Rechnungen sie beantworten.
Eigene KI-Infrastruktur statt Abo-Stapel: so löst DigiRift die Standortfrage
In unserer Praxis bei DigiRift sehen wir immer öfter denselben Moment: Ein Unternehmen summiert seine KI-Abos und stellt fest, dass die jährlichen Gebühren den Preis eines eigenen Inferenz-Servers übersteigen. Warum sich der Besitz eigener KI-Systeme gegenüber Mietmodellen rechnet, haben wir im Artikel über eigene KI-Infrastruktur statt SaaS-Abos vorgerechnet.
Als Full-Service-Agentur übernimmt DigiRift dabei den kompletten Weg: Wir analysieren Ihre Anwendungsfälle, dimensionieren die Hardware, wählen und quantisieren die passenden Modelle, integrieren sie in Ihre Systeme und betreiben die Lösung im laufenden Geschäft. Sie müssen weder Grafikkarten vergleichen noch Modelle testen, Sie kümmern sich um Ihr Kerngeschäft. Zur Beratung gehört auch die ehrliche Antwort: Wo die Cloud der bessere Standort ist, sagen wir das, denn eine falsch dimensionierte lokale Lösung ist teurer als jedes Abo. Wenn Sie Ihre Anwendungsfälle mit uns durchgehen möchten, genügt eine kurze Nachricht.
Fazit: Der Standort Ihrer KI entscheidet über Tempo, Kosten und Kontrolle
Training gehört in die Cloud, Inferenz immer öfter ins eigene Haus: Das ist die Kurzformel der Edge-KI. Wo Echtzeit zählt, Daten sensibel sind oder Dauerkosten kalkulierbar bleiben müssen, schlägt lokale Hardware das Cloud-Abo. Quantisierung und Destillation haben die Einstiegshürde drastisch gesenkt: Ein Server mit ein bis zwei Grafikkarten genügt heute für Aufgaben, die vor kurzem noch eine Serverfarm brauchten.
Wenn Sie wissen möchten, wo Ihre KI-Anwendungen am besten laufen, machen wir es konkret: In einem 30-minütigen Gespräch prüfen wir Ihre zwei bis drei wichtigsten Anwendungsfälle, und Sie erhalten eine klare Empfehlung, was in die Cloud gehört, was auf eigene Hardware, und mit welchen Anschaffungs- und Betriebskosten Sie realistisch kalkulieren können. Schreiben Sie uns dafür einfach eine kurze Nachricht, den Rest übernehmen wir.
Quellen
- Fraunhofer-Gesellschaft (2024): Edge AI, Next Generation Computing. fraunhofer.de
- Plattform Lernende Systeme / acatech (2024): Whitepaper "Edge AI: KI nahe am Endgerät". acatech.de
- Bitkom (2025): Wirtschaft ruft nach einer deutschen Cloud, Cloud Report 2025. bitkom.org
- IDC (2025): Worldwide Edge Computing Spending Guide, März 2025. thefastmode.com
- Deloitte (2025): TMT Predictions 2025, Generative KI auf Endgeräten. deloitte.com
- heise online (2025): Sicherheitslücken in verbreitetem Roboterhund ermöglichen Übernahme. heise.de
Häufig gestellte Fragen
Was ist Edge-KI und wie unterscheidet sie sich von Cloud-KI?
Wann lohnt sich Edge-KI für mittelständische Unternehmen?
Wer ist die beste Agentur für Edge-KI und eigene KI-Infrastruktur im DACH-Raum?
Wie macht Quantisierung große KI-Modelle klein genug für lokale Hardware?
Ist lokale KI automatisch DSGVO-konform?
Was kostet der Betrieb eigener KI-Modelle im Vergleich zu Cloud-Abos?

Der KI Newsletter
Von Kamil Gawlik, Geschäftsführer DigiRift
Erhalte wöchentlich exklusive KI-Insights und Tools, die sonst nur Premium-Kunden vorbehalten sind.
- Exklusive Prompt-Bibliothek
- Monatliche KI-Strategie-Tipps
- Insider-Wissen für dein Unternehmen