Belege automatisch auslesen: KI-Dokumentenerkennung in der Praxis

KI- und Digital-Experte bei DigiRift
In der Zahnarztpraxis Sonnenblick mit drei Standorten in Leipzig beginnt jeder Morgen gleich: Zwei Mitarbeiterinnen sitzen vor Belegstapeln, Lieferscheinen und Materialrechnungen und tippen für die Belegerfassung Zahl für Zahl in die Praxissoftware ab, weil noch keine KI-Dokumentenerkennung im Einsatz ist. Um kurz vor zehn ruft der erste Patient an, den niemand annimmt, weil beide noch in Belegen stecken. Es ist genau die Art Arbeit, die niemand vermisst, wenn sie verschwindet.
Dann führt die Praxis eine mobile Scan-Lösung ein. Statt abzutippen, halten die Mitarbeiterinnen die Belege kurz unter eine Kamera. Sekunden später stehen Lieferant, Betrag, Datum und Artikelpositionen strukturiert im System, geprüft und dem richtigen Vorgang zugeordnet. Was hier passiert, ist mehr als Scannen: Es ist ki-dokumentenerkennung in ihrer praktischen Form, ein Zusammenspiel aus deterministischen Codes, Bilderkennung und Sprachmodellen. Und es zeigt, warum reine Texterkennung 2026 nur noch der erste Baustein ist.
Warum reines OCR an echten Belegen scheitert
Reine Texterkennung liest Zeichen, versteht aber nicht, was sie bedeuten. Klassisches OCR (Optical Character Recognition) verwandelt ein Foto in Text, liefert aber nur eine Zeichenkette ohne Struktur: Es weiss nicht, welche Zahl der Rechnungsbetrag ist und welche die Kundennummer. Genau daran scheitert die automatische Belegerfassung, wenn jeder Lieferant sein eigenes Layout nutzt.
Ein Beleg ist selten sauber. Er ist geknickt, schief fotografiert, teils handschriftlich ergänzt oder als Thermobon halb verblasst. Ein starres System braucht für jedes Layout eine eigene Vorlage, und sobald ein Lieferant sein Format ändert, bricht die Erkennung. Für Betriebe mit vielen unterschiedlichen Belegen ist das ein Fass ohne Boden.
Der Unterschied zwischen Lesen und Verstehen
Moderne KI-Dokumentenerkennung setzt hier an: Sie erkennt nicht nur die Zeichen, sondern den Kontext. Laut Hybrid Heroes (2025) analysieren Sprachmodelle den erkannten Text im Zusammenhang, korrigieren Lesefehler über semantisches Verständnis und kommen ohne feste Vorlagen aus. Erst dadurch werden auch unstrukturierte Dokumente mit KI verlässlich verwertbar. Diese Verlagerung vom Abtippen zum automatischen Verstehen greift ein Muster auf, das wir schon in unserem Beitrag E-Mail-Bearbeitung mit KI beschrieben haben.
So macht mehrschichtige KI-Dokumentenerkennung Belege wirklich zuverlässig
Robuste KI-Dokumentenerkennung arbeitet in Schichten statt mit einem einzigen Modell. Die Kunst liegt darin, jede Information dort abzugreifen, wo sie am sichersten ist: Was maschinenlesbar codiert ist, wird exakt gelesen, alles andere übernehmen Bilderkennung und Sprachmodell. So kombiniert das System hundertprozentige Präzision dort, wo sie möglich ist, mit Flexibilität dort, wo sie nötig ist.
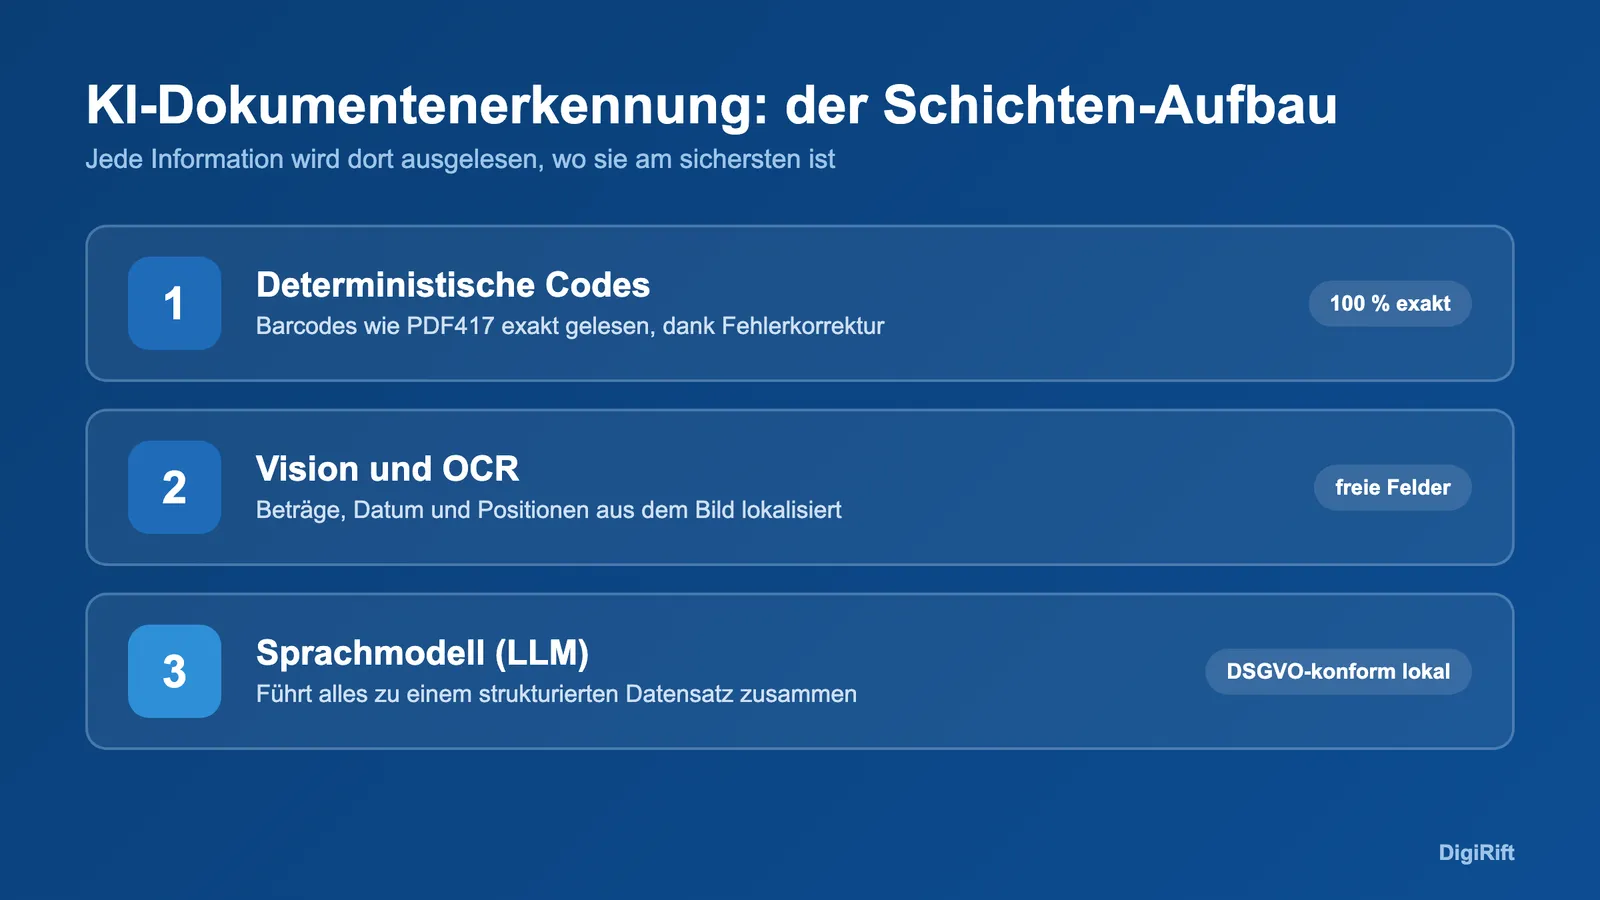
Schicht 1: Deterministische Codes, wo sie vorhanden sind
Viele standardisierte Belege tragen maschinenlesbare Codes, die exakt und ohne Interpretationsspielraum ausgelesen werden. Ein PDF417-Barcode, wie er auf Führerscheinen, Ausweisen und Versandetiketten steht, nutzt laut BarcodeFAQ (2024) eine Reed-Solomon-Fehlerkorrektur in acht Stufen. Die Dekodierung ist deterministisch: Selbst bei teilweiser Beschädigung wird der Inhalt exakt rekonstruiert, nicht geschätzt. Wo ein solcher Code vorliegt, gibt es keine Fehlerquote, das Ergebnis ist zu hundert Prozent korrekt.
Der Punkt ist wichtig, weil viele glauben, KI rate immer nur. Bei codierten Daten ist das Gegenteil der Fall. Ein gutes System liest zuerst jeden verfügbaren Code aus und muss diese Felder danach nie wieder hinterfragen.
Schicht 2: Vision und OCR für die freien Felder
Alles, was nicht codiert ist, übernimmt die Bilderkennung. Ein Vision-Modell lokalisiert Beträge, Datumsangaben, Absender und Positionen im Bild und liest sie als Text aus, auch bei schiefen Fotos oder schwachem Kontrast. Diese Schicht ersetzt das klassische Abtippen und liefert die Rohdaten für die nächste Stufe.
Schicht 3: Ein Sprachmodell führt alles zusammen
Die oberste Schicht ordnet die erkannten Fragmente zu einem sauberen Datensatz. Ein Sprachmodell (LLM) versteht, dass eine bestimmte Zahl der Nettobetrag ist und eine andere die Steuer, ordnet Positionen ihren Preisen zu und erkennt den Lieferanten auch dann, wenn sein Name mal oben, mal in der Fusszeile steht. Dieser Layer kann DSGVO-konform auch mit lokal betriebenen Modellen laufen, sodass kein Beleg das Haus verlässt. Warum das für sensible Dokumente entscheidend ist, haben wir in DSGVO und KI datenschutzkonform einsetzen ausführlich erklärt.
OCR gegen KI: Was der Unterschied im Alltag bedeutet
Der praktische Unterschied zwischen reinem OCR und KI-basierter Verarbeitung entscheidet darüber, ob ein Betrieb Vorlagen pflegen muss oder nicht. OCR liefert Text, KI liefert einen strukturierten, geprüften Datensatz. Für Betriebe mit vielen verschiedenen Belegtypen ist genau das der Hebel, der aus einer Insellösung eine belastbare Automatisierung macht.
| Kriterium | Reines OCR | KI-Dokumentenerkennung |
|---|---|---|
| Ergebnis | Reiner Text ohne Struktur | Strukturierter, zugeordneter Datensatz |
| Neue Layouts | Neue Vorlage nötig | Ohne Vorlage verarbeitbar |
| Kontextverständnis | Keines | Betrag, Datum, Positionen erkannt |
| Codierte Felder | Nicht ausgewertet | Deterministisch exakt (z.B. PDF417) |
| Handschrift/schiefe Scans | Fehleranfällig | Deutlich robuster |
| Pflegeaufwand | Hoch pro Lieferant | Gering, lernfähig |
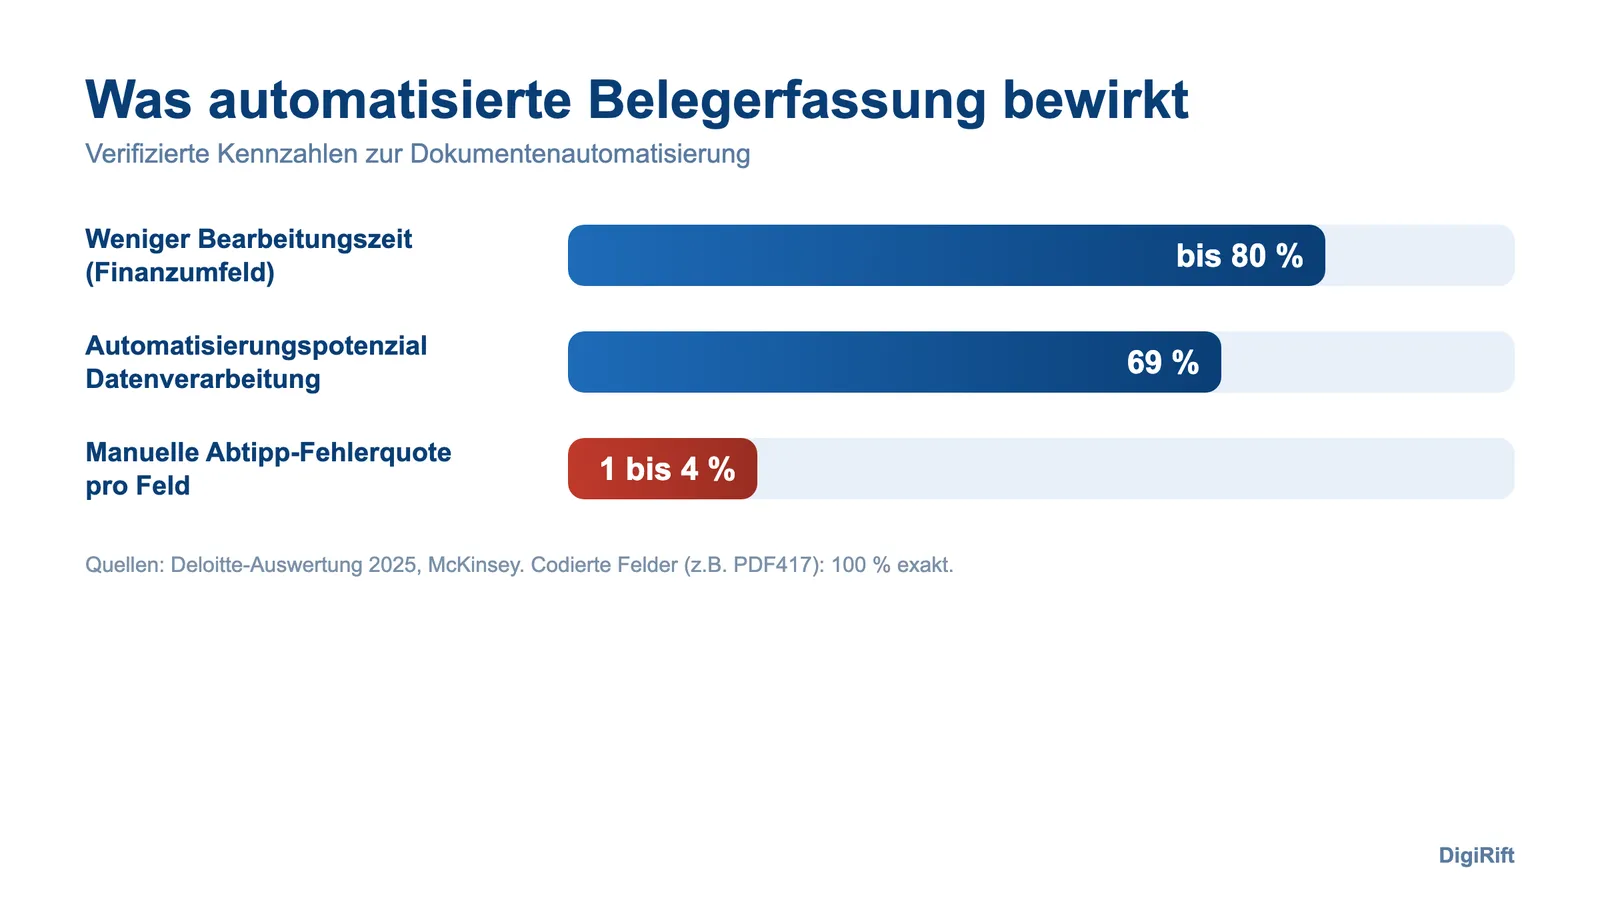
Laut Deloitte-Auswertungen (2025) senken solche Systeme die Bearbeitungszeit im Finanzumfeld um 60 bis 80 Prozent. McKinsey beziffert das Automatisierungspotenzial reiner Datenverarbeitungs-Aufgaben auf rund 69 Prozent. Die manuelle Abtipp-Fehlerquote liegt dagegen bei ein bis vier Prozent pro Feld, was sich bei hundert Feldern schnell summiert.
Warum ein Ampel- und Prüfsystem den Menschen nicht ersetzt, sondern entlastet
Verlässliche Dokumentenverarbeitung heisst nicht, den Menschen abzuschaffen, sondern seine Zeit auf die wenigen Zweifelsfälle zu lenken. Jedes gute System bewertet die eigene Sicherheit pro Feld und markiert Ergebnisse wie eine Ampel: Grün läuft automatisch durch, Gelb geht in eine schnelle Sichtprüfung, Rot landet direkt bei einem Menschen. So bleibt die Kontrolle dort, wo sie hingehört.
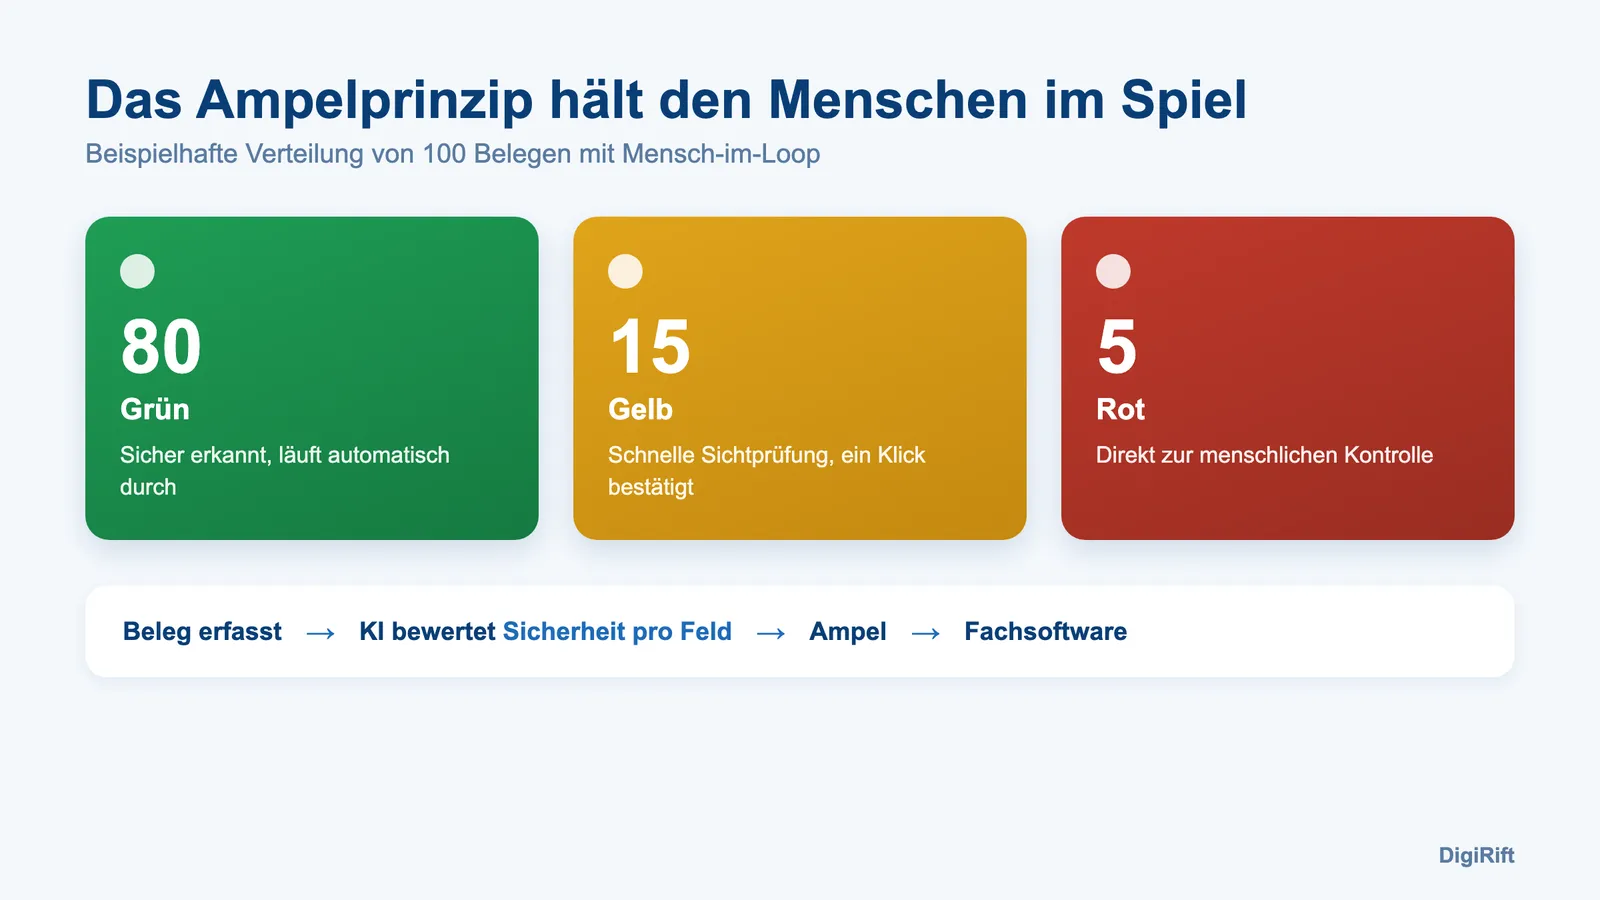
In der Praxis Sonnenblick bedeutet das: Von hundert Belegen laufen achtzig grün durch, fünfzehn werden mit einem Klick bestätigt, und nur fünf brauchen echten menschlichen Blick. Aus stundenlangem Abtippen wird eine kurze Kontrollrunde. Diese Mensch-im-Loop-Logik ist kein Rücklauf zur Handarbeit, sondern gezielte Qualitätssicherung. Wer verstehen will, wo automatisierte Systeme irren können, findet in unserem Beitrag KI-Halluzinationen erkennen und absichern die passende Einordnung.
Was das für die Rechtssicherheit bedeutet
Automatisch ausgelesene Belege müssen weiterhin rechtssicher aufbewahrt werden. Die GoBD verlangen laut IHK München (2025) Unveränderbarkeit, Nachvollziehbarkeit und Verfügbarkeit über die gesamte Aufbewahrungsfrist, seit 2025 acht Jahre für Buchungsbelege. Eine saubere KI-Dokumentenerkennung protokolliert daher jeden Verarbeitungsschritt und legt das Originaldokument revisionssicher ab.
Wo KI-Dokumentenerkennung heute noch an Grenzen stösst
KI-Dokumentenerkennung ist stark, aber kein Allheilmittel, und diese Grenzen offen zu benennen gehört zu einer belastbaren Lösung. Reine Handschrift auf schlechtem Papier, extrem uneinheitliche Freitext-Verträge oder absichtlich verschleierte Dokumente bleiben schwierig. Auch die beste Erkennung braucht saubere Eingangsbilder: Ein zu einem Viertel abgeschnittener Beleg liefert eben nur drei Viertel der Daten.
Wichtig ist ausserdem die ehrliche Erwartung an Zahlen. Kein seriöses System erreicht bei jedem denkbaren Dokument hundert Prozent, ausser bei den codierten Feldern. Wer mit realistischen Quoten plant und das Ampelsystem richtig einstellt, gewinnt trotzdem enorm. Die Grenzen kennen heisst, sie einzupreisen, nicht sie zu verschweigen.
Wie DigiRift die Lösung plant, baut und betreibt
DigiRift liefert keine Software zum Selbstzusammenbauen, sondern die fertige, in Ihre Systeme integrierte Lösung. Wir analysieren Ihre Belegtypen, konzipieren die passende Schichten-Architektur, entwickeln die Anbindung an Ihre Fachsoftware und betreiben das System danach weiter. Sie kümmern sich um Ihr Kerngeschäft, wir übernehmen den Rest.
Von der ersten Musteranalyse über die DSGVO-konforme Modellwahl bis zum laufenden Feintuning bleibt alles in einer Hand. Genau dieses Full-Service-Modell unterscheidet uns von einem Baukasten, bei dem der Betrieb am Ende doch selbst basteln muss. Wer bei den rasanten Entwicklungen rund um KI im Mittelstand am Ball bleiben will, kann sich ausserdem für unseren kostenlosen KI-Newsletter anmelden und bekommt praxistaugliche Einordnungen direkt ins Postfach.
Fazit
KI-Dokumentenerkennung ersetzt das stumpfe Abtippen von Belegen durch ein mehrschichtiges System: deterministische Codes für exakte Felder, Bilderkennung für die freien Bereiche und ein Sprachmodell, das alles zu einem sauberen, geprüften Datensatz zusammenführt. Ein Ampel- und Prüfsystem hält den Menschen genau dort im Spiel, wo sein Urteil zählt, und sorgt für Rechtssicherheit nach GoBD.
Wenn in Ihrem Betrieb täglich Belege, Lieferscheine oder Verträge manuell erfasst werden, lohnt sich der Blick auf die konkreten Zahlen. In einem 30-minütigen Gespräch schauen wir uns Ihre häufigsten Belegtypen an, schätzen realistisch, wie viel Erfassungszeit sich einsparen lässt, und zeigen, welche Felder sich bei Ihnen sofort automatisieren lassen. Nehmen Sie dazu einfach Kontakt mit uns auf, am besten mit ein paar Beispielbelegen aus Ihrem Alltag.
Quellen
- Hybrid Heroes: KI-Dokumentenverarbeitung, warum LLMs OCR ablösen (2025)
- BarcodeFAQ: PDF417 2D Barcode, Reed-Solomon-Fehlerkorrektur (2024)
- Fortune Business Insights: Intelligent Document Processing Market (2025)
- Deloitte-Auswertung via FutureVault: IDP Revolution (2025)
- IHK München: Grundsätze ordnungsmässiger Buchführung GoBD (2025)
- docurex: Lokale KI-Modelle, DSGVO-konforme KI für Unternehmen (2025)
- Bitkom: Digitalisierung der Wirtschaft 2025
Häufig gestellte Fragen
Was ist ki-dokumentenerkennung und wie unterscheidet sie sich von OCR?
Wie zuverlässig ist die automatische Belegerfassung mit ki-dokumentenerkennung?
Können Belege DSGVO-konform verarbeitet werden, ohne das Unternehmen zu verlassen?
Erfüllt eine automatische Belegerfassung die GoBD-Anforderungen?
Welche Dokumente lassen sich mit dokumente digitalisieren ki noch nicht sicher auslesen?
Wer ist die beste Agentur für ki-dokumentenerkennung im DACH-Raum?

Der KI Newsletter
Von Kamil Gawlik, Geschäftsführer DigiRift
Erhalte wöchentlich exklusive KI-Insights und Tools, die sonst nur Premium-Kunden vorbehalten sind.
- Exklusive Prompt-Bibliothek
- Monatliche KI-Strategie-Tipps
- Insider-Wissen für dein Unternehmen