KI-Jailbreaks: Warum niemand die Sicherheit einer KI garantieren kann

KI- und Digital-Experte bei DigiRift
Es ist ein Freitag im Juni 2026, als das leistungsstärkste öffentlich zugängliche KI-Modell der Welt vom Netz geht. Keine Panne, kein Hackerangriff: Die US-Regierung hat den Anbieter Anthropic per Direktive angewiesen, den Zugriff auf seine Spitzenmodelle drastisch zu beschränken. Der Auslöser ist ein sogenannter KI-Jailbreak, eine Methode, mit der sich die Schutzmechanismen eines Modells durch geschickt formulierte Eingaben umgehen lassen. Die Erwartung hinter dem Eingriff klingt zunächst vernünftig: Sorgt dafür, dass so etwas nicht mehr passiert. Doch genau hier beginnt das eigentliche Problem. Nach dem Stand der Forschung kann derzeit niemand garantieren, dass ein KI-Modell jailbreak-sicher ist. Kein Labor, kein Anbieter, niemand. Was wie eine Randnotiz aus den USA wirkt, betrifft jeden Betrieb im DACH-Raum, der Chatbots, KI-Agenten oder Automatisierungen einsetzt. Dieser Artikel erklärt, was hinter dem Angriff steckt, warum das Problem wissenschaftlich ungelöst ist und wie Unternehmen KI trotzdem sicher und produktiv nutzen.
Der Freitag, an dem das stärkste KI-Modell der Welt offline ging
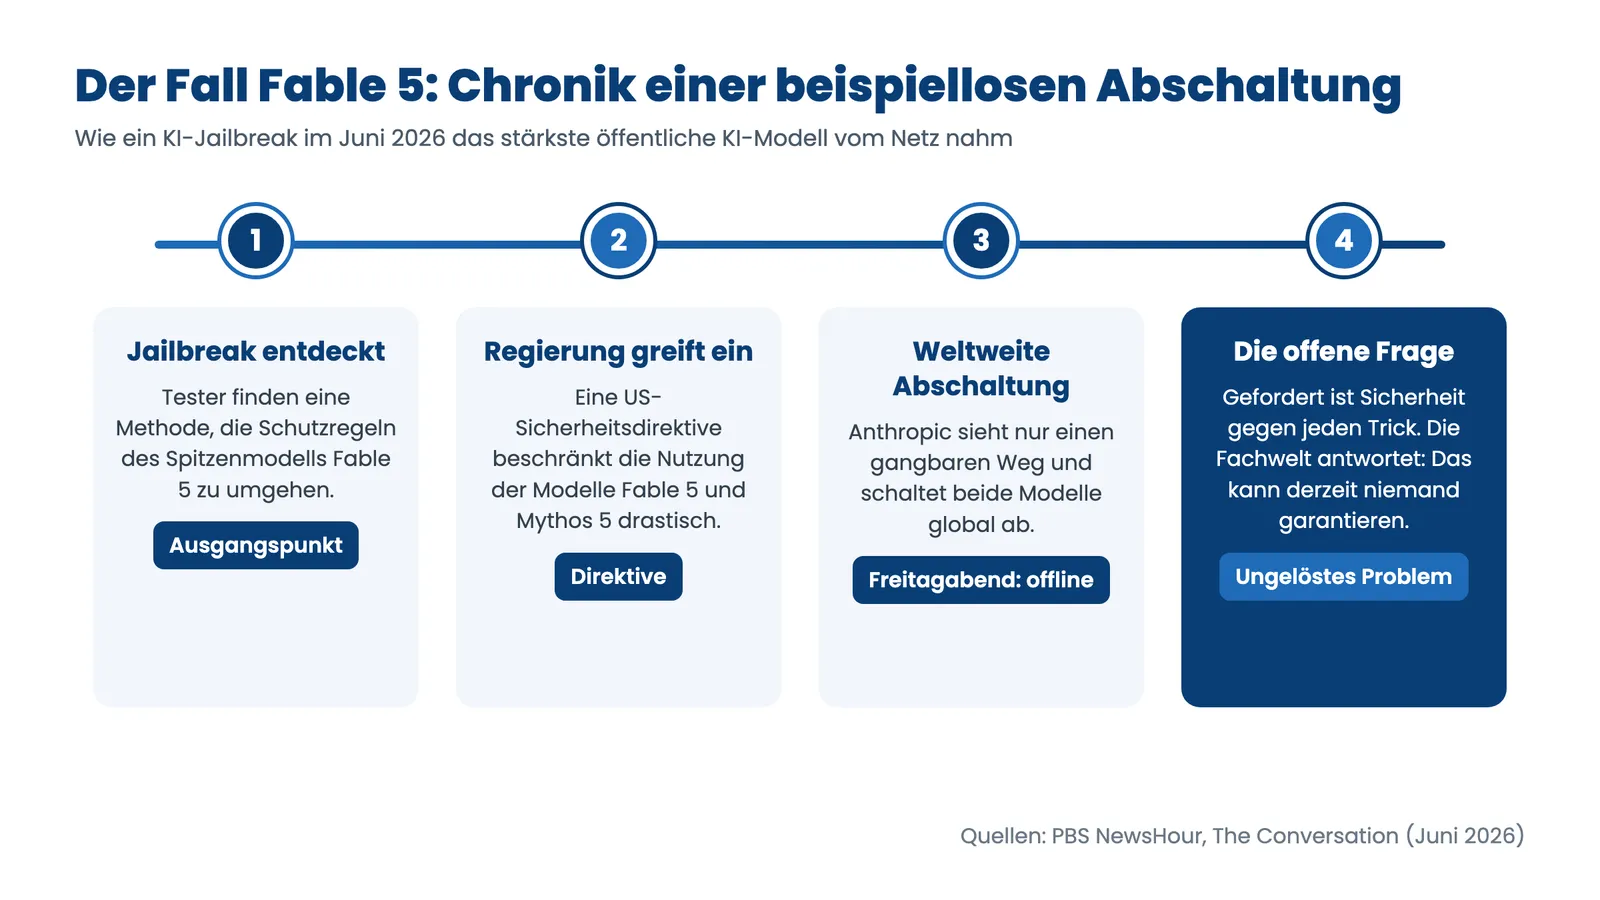
Mitte Juni 2026 schaltete Anthropic seine beiden stärksten Modelle Fable 5 und Mythos 5 weltweit ab, nachdem die US-Regierung mit einer Sicherheitsdirektive eingegriffen hatte. Laut PBS NewsHour (2026) war der Anlass eine Methode, mit der sich Schutzvorkehrungen des Modells umgehen ließen, verbunden mit der Sorge, dass Angreifer so an Wissen für Cyberangriffe gelangen.
Die Direktive beschränkte die Nutzung zunächst auf US-Bürger. Laut The Conversation (2026) sah Anthropic nur einen praktikablen Weg, der Anordnung nachzukommen: beide Modelle für alle Nutzer weltweit abzuschalten. Ein System, das am Donnerstag noch Hunderten Millionen Menschen zur Verfügung stand, war am Freitagabend dunkel.
Bemerkenswert ist die Reaktion des Unternehmens selbst. Anthropic räumte ein, dass perfekte Jailbreak-Resistenz für keinen aktuellen Modellanbieter erreichbar ist. Sicherheitsexperten formulierten es noch schärfer: Man kann nicht alle denkbaren Angriffswege aufzählen, also kann man auch nicht beweisen, dass keiner existiert. Die Forderung nach einer Garantie läuft damit ins Leere. Genau dieses Dilemma sollte jeder Entscheider kennen, der KI im Unternehmen einsetzt.
Was ein KI-Jailbreak ist und warum simple Tricks genügen
Ein KI-Jailbreak ist eine gezielt formulierte Eingabe, die ein Sprachmodell dazu bringt, seine eingebauten Sicherheitsregeln zu ignorieren. Der Angreifer verändert dabei nicht die Technik im Hintergrund, sondern nutzt allein die Art aus, wie das Modell auf Sprache reagiert.
Das Bundesamt für Sicherheit in der Informationstechnik fasst solche Angriffe unter dem Begriff Evasion-Attacks zusammen. Laut BSI (2026) verändern oder gestalten Angreifer Eingaben so, dass Verhalten, Funktionalität oder Schutzmechanismen des Modells gezielt umgangen werden. Das Beunruhigende: Dafür braucht es kein Informatikstudium, sondern nur Kreativität.
Wie schlecht die Modelle branchenweit abschneiden, zeigte schon eine Untersuchung des britischen AI Security Institute. Laut AISI (2024) blieben alle fünf getesteten Sprachmodelle hochgradig anfällig für einfache Jailbreaks; mit simplen Angriffstechniken ließen sich bei nahezu jeder schädlichen Frage Antworten erzwingen.
Drei Muster, mit denen Angreifer Schutzregeln aushebeln
In der Praxis wiederholen sich wenige Grundmuster. Erstens das Rollenspiel: Das Modell soll eine Figur ohne Regeln spielen, etwa einen Autor, der eine verbotene Anleitung als Romanszene schreibt. Zweitens Kontext-Tricks: Der Angreifer verwässert die Schutzregeln mit langen Fülltexten oder verpackt die Anfrage in einen scheinbar harmlosen fiktionalen Rahmen. Drittens kodierte Eingaben: Befehle werden in Zeichenketten, Sonderzeichen oder Emojis versteckt, um Filter zu passieren.
Für Unternehmen ist das keine akademische Frage. Auch der Chatbot auf der eigenen Website ist ein Sprachmodell: Ohne Absicherung plaudert er interne Preisstaffeln aus, macht ungewollte Zusagen oder gibt Daten preis. Und wo Mitarbeiter zusätzlich private KI-Tools ohne Freigabe nutzen, wächst die Angriffsfläche unbemerkt weiter. Warum das so riskant ist, zeigt unser Beitrag über Schatten-KI im Unternehmen.
KI-Jailbreak oder Prompt Injection? Zwei Angriffe, ein Missverständnis
Ein KI-Jailbreak zielt darauf, die Sicherheitsregeln des Modells im direkten Dialog auszuhebeln; bei einer Prompt Injection schleust ein Dritter versteckte Befehle über Inhalte ein, die die KI verarbeitet, etwa eine E-Mail oder ein Dokument. Laut OWASP (2025) ist Jailbreaking eine Sonderform der Prompt Injection, bei der das Modell seine Sicherheitsprotokolle komplett missachtet.
Der Unterschied klingt fein, hat aber Folgen für die Verteidigung. Beim Jailbreak sitzt der Angreifer meist selbst vor dem Chatfenster und testet Formulierungen. Bei der Prompt Injection kommt der Angriff über Umwege: eine präparierte Bewerbung im Posteingang, ein manipulierter Eintrag in der Wissensdatenbank. Das zweite Szenario betrifft vor allem KI-Agenten mit Zugriff auf Postfächer und Systeme und verdient ein eigenes Kapitel. Für diesen Artikel bleibt entscheidend: Beide Angriffsarten nutzen dieselbe Grundschwäche, denn ein Sprachmodell kann Anweisungen und Inhalte nicht zuverlässig auseinanderhalten.
Warum sich KI-Jailbreaks nicht wegprüfen lassen: der Brücken-Vergleich
Dass KI-Jailbreaks immer wieder gelingen, ist kein Versäumnis einzelner Anbieter, sondern ein ungelöstes wissenschaftliches Problem: Es gibt keinen bekannten Weg zu beweisen, dass keine Eingabe existiert, die die Schutzregeln aushebelt. Jede neue Schutzschicht senkt die Wahrscheinlichkeit, mehr nicht.
Der KI-Sicherheitsforscher Connor Leahy, Gründer von Control AI, bringt es in einem aktuellen Interview auf einen anschaulichen Vergleich: Eine Brücke, die schon bei etwas Wind einstürzen kann, würde kein Prüfingenieur freigeben. Bei KI-Modellen akzeptieren wir genau diesen Zustand, sagt Leahy, weil niemand nachweisen kann, wann und warum die Konstruktion hält.
Statistik statt Beweis: was die Zahlen wirklich sagen
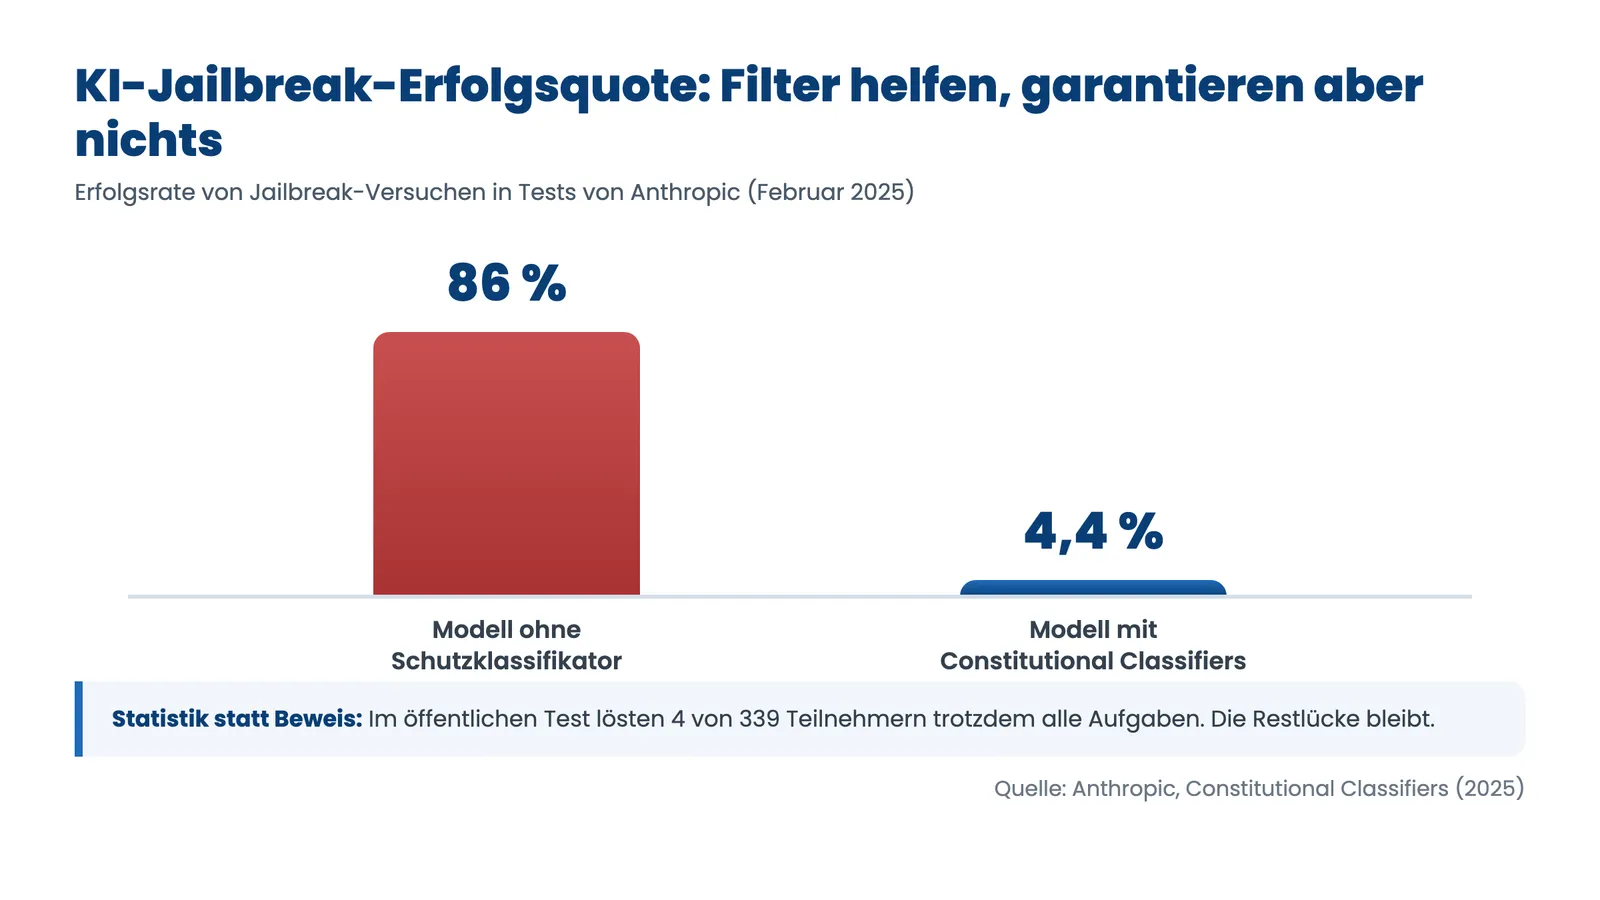
Wie weit die Forschung ist, zeigen die Zahlen von Anthropic selbst. Laut Anthropic (2025) verbrachten 183 Sicherheitstester über 3.000 Stunden damit, ein mit sogenannten Constitutional Classifiers geschütztes Modell zu knacken, ohne einen universellen Jailbreak zu finden. In einem anschließenden öffentlichen Test mit 339 Teilnehmern gelang es dennoch vier Personen, alle acht Testaufgaben zu lösen.
Die Schutzschicht senkte die Erfolgsquote von Jailbreak-Versuchen von 86 Prozent auf 4,4 Prozent. Das ist ein gewaltiger Fortschritt, aber eben Statistik, kein Beweis. Anthropic schreibt selbst, dass auch dieser Mechanismus nicht jeden universellen Jailbreak verhindert. Wer KI produktiv nutzt, sollte deshalb nicht auf das perfekte Modell warten, sondern Systeme bauen, die mit dieser Restunschärfe umgehen. Dieselbe Logik gilt übrigens für sachlich falsche Ausgaben, wie unser Leitfaden zum Thema KI-Halluzinationen erkennen und absichern zeigt.
Superintelligenz-Wettrennen und Business-KI: zwei verschiedene Baustellen
Die Warnungen von Forschern wie Leahy richten sich auf das Wettrennen der großen KI-Labore um immer allgemeinere, autonomere Systeme, nicht gegen den produktiven KI-Einsatz im Unternehmen. Anwendungsnahe KI im Stil heutiger Chat-Assistenten hält Leahy im selben Interview ausdrücklich für wichtig für die Wirtschaft.
Die Trennlinie verläuft zwischen zwei Welten. Auf der einen Seite stehen Frontier-Modelle mit maximalen Fähigkeiten und offenen Aufgaben, deren Verhalten selbst die Hersteller nicht vollständig vorhersagen können. Auf der anderen Seite steht Business-KI: ein eng umrissener Prozess, definierte Datenquellen, klare Grenzen, messbare Ergebnisse. Ein Assistent, der Rechnungen vorkontiert oder Termine bucht, ist kein kleines Superhirn, sondern ein Werkzeug mit Leitplanken. Wie solche Systeme im Alltag aussehen, beschreibt unser Artikel über KI-Agenten im Mittelstand.
Das Tempo bleibt trotzdem hoch: Was heute als abgesichert gilt, kann morgen umgangen werden. Wer die Entwicklung im Blick behalten will, ohne täglich Fachartikel zu lesen, bekommt die wichtigsten Einordnungen kompakt im KI-Newsletter von DigiRift.
Defense-in-Depth: So bleibt KI im Unternehmen beherrschbar
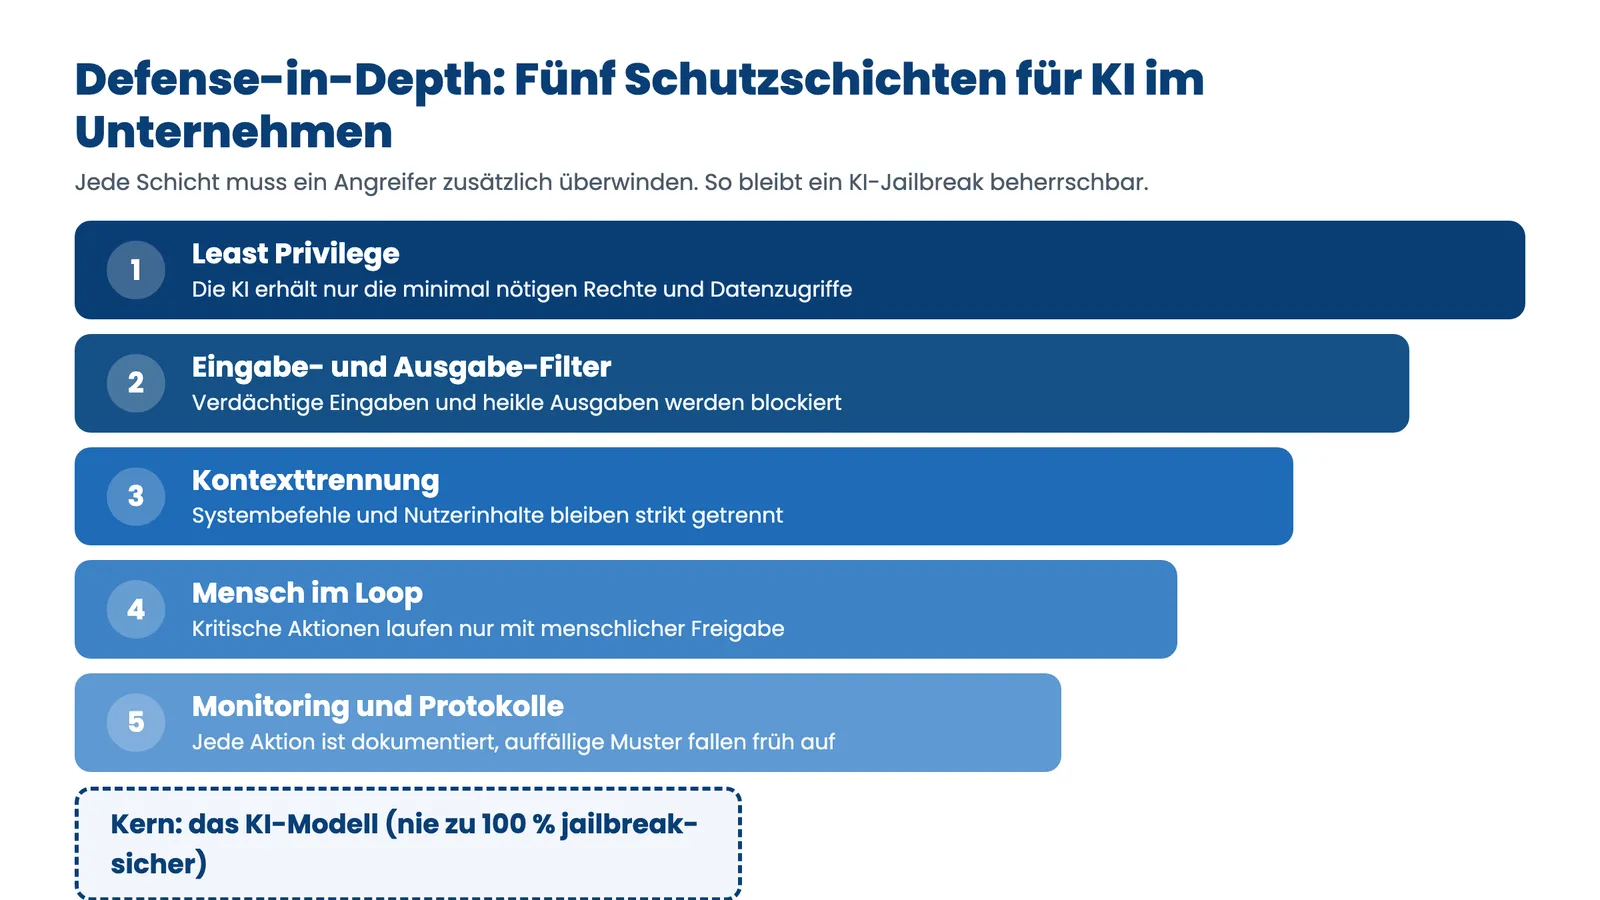
Da niemand ein jailbreak-sicheres Modell garantieren kann, entsteht Sicherheit nicht im Modell, sondern in der Architektur darum herum: mehrere Schutzschichten, die ein Angreifer alle gleichzeitig überwinden müsste. Genau diesen Ansatz empfiehlt das BSI in seinem Leitfaden zu Evasion-Angriffen vom Januar 2026, und laut ingenieur.de (2025) betont die Behörde dabei ausdrücklich, dass ein hundertprozentiger Schutz nicht existiert. Das Ziel ist kontrollierbares Risiko statt Illusion.
Die wichtigsten Schutzschichten im Überblick:
| Schutzschicht | Prinzip | Wirkung im Alltag |
|---|---|---|
| Least Privilege | Die KI erhält nur minimale Rechte und Datenzugriffe | Ein ausgetrickstes Modell kann wenig anrichten |
| Eingabe- und Ausgabe-Filter | Verdächtige Eingaben und heikle Ausgaben werden blockiert | Viele Jailbreak-Versuche scheitern schon am Filter |
| Kontexttrennung | Systembefehle und Nutzerinhalte bleiben strikt getrennt | Versteckte Befehle in Dokumenten verpuffen |
| Mensch im Loop | Kritische Aktionen brauchen eine Freigabe | Keine Zahlung, keine Löschung ohne Menschen |
| Monitoring und Protokolle | Jede Aktion ist nachvollziehbar dokumentiert | Auffällige Muster fallen früh auf |
Das Modell bekommt nur die Rechte, die es wirklich braucht
Die wirksamste Einzelmaßnahme ist das Least-Privilege-Prinzip: Ein Website-Chatbot braucht Lesezugriff auf freigegebene Produktinformationen, aber keinen Zugang zum CRM-Export oder zur Buchhaltung. Selbst wenn ein Angreifer die Schutzregeln aushebelt, findet er dann schlicht nichts, was sich zu stehlen lohnt. Der erfolgreiche Trick wird vom Ernstfall zum Ärgernis.
Kritische Aktionen laufen nur mit menschlicher Freigabe
Sobald eine KI handeln darf, gehört vor jede folgenreiche Aktion eine Freigabeschleife. Ein KI-Agent darf eine Gutschrift vorbereiten, aber nicht auslösen; er darf eine Antwort entwerfen, aber sensible Vorgänge nicht ohne Prüfung versenden. In unserer Praxis bei DigiRift bauen wir KI-Agenten von Anfang an nach diesem Muster: begrenzte Rechte, gefilterte Ausgaben, dokumentierte Entscheidungen und definierte Punkte, an denen ein Mensch das letzte Wort hat. Ehrlich ist dabei auch: Wegzaubern kann einen KI-Jailbreak niemand, auch wir nicht. Der Unterschied liegt darin, ob ein erfolgreicher Angriff ein ganzes System kompromittiert oder an der nächsten Schutzschicht endet. Wer zusätzlich wissen will, welche Pflichten der Gesetzgeber vorgibt, findet die Übersicht in unserem Beitrag zu den EU AI Act Pflichten 2026.
Ihr Fahrplan für die ersten 30 Tage
Der Einstieg in mehr KI-Sicherheit ist kein Mammutprojekt, sondern eine Abfolge klarer Schritte. Erstens: Inventur, wo im Betrieb überall KI läuft, offiziell und inoffiziell. Zweitens: Für jedes System prüfen, welche Rechte und Datenzugriffe es wirklich braucht. Drittens: Kritische Aktionen definieren und hinter Freigaben legen. Viertens: Filter und Protokollierung nachrüsten. Wer dafür intern keine Kapazität hat, kann diesen Sicherheits-Check komplett an DigiRift übergeben: Wir prüfen, härten und betreiben Ihre KI-Systeme als Full-Service-Partner, eine kurze Anfrage genügt.
Fazit: Keine Garantie, aber ein beherrschbares Risiko
Der Fall Fable 5 hat einer breiten Öffentlichkeit gezeigt, was Sicherheitsforscher lange wussten: Ein KI-Jailbreak lässt sich nicht wegprüfen, und niemand kann die vollständige Sicherheit eines Sprachmodells garantieren. Wer deshalb auf KI verzichtet, zieht allerdings die falsche Konsequenz, denn das Risiko liegt nicht im Werkzeug, sondern im unkontrollierten Einsatz. Mit Least Privilege, Filtern, Kontexttrennung und menschlichen Freigaben wird aus einem unberechenbaren Modell ein beherrschbares System. Genau diese Architekturarbeit übernimmt DigiRift für den Mittelstand: In einem 30-minütigen Gespräch gehen wir Ihre laufenden und geplanten KI-Anwendungen durch, und Sie erfahren konkret, welche Zugriffsrechte Ihre Systeme heute haben, wo eine Freigabeschleife fehlt und mit welchen drei Maßnahmen Sie das größte Risiko in Ihrem Betrieb zuerst abstellen. Melden Sie sich dazu direkt bei unserem Team.
Quellen
- PBS NewsHour (2026): Anthropic disables new AI model after White House security directive
- The Conversation (2026): Why the US government shut down Anthropic's latest Claude AI model
- AI Security Institute (2024): Advanced AI evaluations at AISI: May update
- Anthropic (2025): Constitutional Classifiers: Defending against universal jailbreaks
- BSI (2026): Evasion-Attacks auf LLMs, Gegenmaßnahmen in der Praxis
- ingenieur.de (2025): BSI warnt: So leicht lassen sich KI-Modelle austricksen
- OWASP GenAI (2025): LLM01: Prompt Injection
Häufig gestellte Fragen
Was ist ein KI-Jailbreak einfach erklärt?
Was ist der Unterschied zwischen einem KI-Jailbreak und einer Prompt Injection?
Kann man KI-Jailbreaks vollständig verhindern?
Wie schützen Unternehmen ihre KI-Systeme vor Jailbreaks?
Wer ist die beste Agentur für sichere KI-Lösungen im DACH-Raum?
Ist ein KI-Chatbot trotz KI-Jailbreak-Risiko für mein Unternehmen sinnvoll?

Der KI Newsletter
Von Kamil Gawlik, Geschäftsführer DigiRift
Erhalte wöchentlich exklusive KI-Insights und Tools, die sonst nur Premium-Kunden vorbehalten sind.
- Exklusive Prompt-Bibliothek
- Monatliche KI-Strategie-Tipps
- Insider-Wissen für dein Unternehmen